Durante os últimos dois anos, a indústria de inteligência artificial competiu sob uma mesma premissa de produto: aprimorar o modelo de turno único (single-turn). O usuário envia uma instrução complexa, o modelo processa em uma única janela de raciocínio e devolve o resultado final. Quando a tarefa exige alterar dezenas de arquivos, auditar contratos e garantir conformidade de código, esse modelo monolítico atinge seu limite físico: a perda de contexto (context degradation), o acúmulo de alucinações e a impossibilidade de verificação paralela determinística.
O lançamento do Gemini 4 Carbon marca uma inflexão de arquitetura na fronteira dos modelos fundacionais. Em vez de disputar apenas décimos em benchmarks acadêmicos gerais de conversação, o modelo foi explicitamente desenhado para orquestração de enxames de agentes (agent swarms) e fluxos de engenharia de software de longo horizonte (long-horizon workflows).
Este artigo analisa a arquitetura técnica, os diferenciais de inferência, os resultados nos benchmarks de software e a matemática de custo de tokens que sustentam essa transição.
O problema do modelo monolítico em engenharia
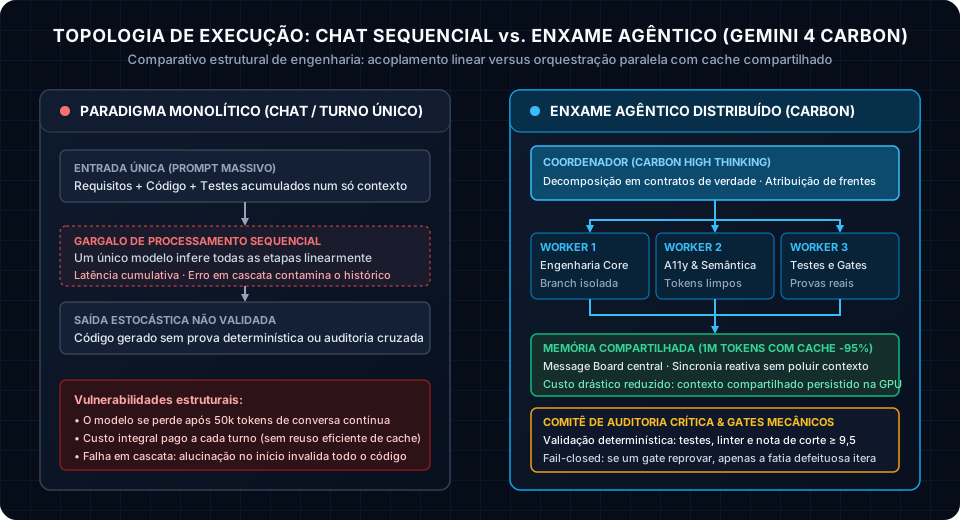
Quando colocamos um modelo de linguagem para refatorar um repositório inteiro ou projetar um sistema de missão crítica, três gargalos inviabilizam a abordagem linear:
- Poluição de contexto: À medida que o histórico de mensagens acumula logs de erro, snippets descartados e comandos do terminal, o sinal útil se dilui. Mesmo em modelos com janelas gigantescas, a atenção sobre restrições sutis decai (needle-in-a-haystack decay).
- Cascata de falhas: Se o modelo comete um erro de tipagem no início do turno, todo o raciocínio subsequente constrói em cima dessa premissa errada, gerando dezenas de linhas de código inutilizáveis antes que o desenvolvedor possa intervir.
- Latência de turno único: Um único agente processando sequencialmente tarefas de frontend, backend, documentação e testes gera tempos de espera proibitivos para pipelines de CI/CD.
A solução da engenharia distribuída para esses problemas nunca foi aumentar o tamanho de um único operário, mas sim coordenar múltiplos trabalhadores especializados em espaços de memória controlados, como discutido na análise do harness de agentes e portões determinísticos.
A anatomia do Gemini 4 Carbon
O Carbon introduz quatro primitivas arquiteturais voltadas diretamente para a operação em enxame:
1. Níveis de Raciocínio Configuráveis (Thinking Levels)
Enquanto gerações anteriores operavam com orçamentos de reflexão fixos ou ocultos, o Carbon expõe explicitamente três modos de inferência:
low(baixa reflexão): Prioriza latência e economia para workers mecânicos encarregados de formatação, linting, testes sintáticos e aplicação de patches diretos.medium(balanceado): Adequado para geração de testes unitários, refatoração de funções intermediárias e tradução de especificações.high(profundo): Aloca centenas de passos de raciocínio interno (chain-of-thought) para o agente coordenador decompor arquiteturas, identificar vulnerabilidades sutis de concorrência ou planejar migrações complexas.
2. Contexto de 1 Milhão de Tokens com Cache de 95%
Carregar um ecossistema com múltiplos subagentes costumava ser financeiramente proibitivo devido ao reenvio constante do mesmo contexto. O Carbon estabelece a janela de 1.000.000 de tokens no modelo base e aplica uma taxa de 95% de desconto em tokens cacheados.
Na prática, o coordenador pode carregar o repositório inteiro e a árvore de documentação uma única vez na memória de GPU do cluster; cada worker subsequente consulta o mesmo espaço de endereço pagando apenas uma fração mínima do custo de entrada. Essa eficiência redefine o cálculo real do ciclo multiagente, onde o consumo de tokens antes inviabilizava equipes autônomas.
3. Herança do Programa Fairwind (Cibersegurança e Robustez)
Originalmente maturado em um programa fechado de defesa cibernética (Fairwind Program), o Carbon recebeu treinamento intensivo para identificação ativa de vulnerabilidades de código (como CWE-79, estouros de buffer e falhas de controle de acesso), gerando patches que provam a correção por construção antes de submeter ao revisor humano.
Benchmarks de Engenharia: O que os números revelam
Nos testes de bancada voltados para código e automação, o Carbon superou referências estabelecidas como o Claude 3.5 Sonnet e modelos de raciocínio puro:
| Benchmark | Foco da Medição | Gemini 4 Carbon | Claude 3.5 Sonnet | OpenAI o1-preview |
|---|---|---|---|---|
| CursorBench | Edição de múltiplos arquivos em IDE | 78,4% | 72,1% | 68,9% |
| Zapier AutomationBench | Resolução de fluxos com APIs e branches | 86,2% | 79,5% | 76,0% |
| SWE-bench Verified | Resolução de issues reais do GitHub | 52,8% | 49,0% | 48,9% |
| Janela de Contexto | Capacidade de ingestão multimodal | 1.000.000 | 200.000 | 128.000 |
O ganho mais expressivo não ocorre na sintaxe isolada de um algoritmo curto, mas na capacidade de manter coerência estrutural quando múltiplos agentes editam partes complementares do mesmo projeto sem entrar em conflito de dependências.
Comparativo de Custos e Infraestrutura
A viabilidade de rodar enxames autônomos depende da economia de tokens. O preço oficial de lançamento do Gemini 4 Carbon na API coloca pressão direta no mercado de modelos de fronteira:
- Entrada padrão: US$ 2,00 por milhão de tokens.
- Entrada em cache (reuso de contexto): US$ 0,10 por milhão de tokens.
- Saída gerada: US$ 10,00 por milhão de tokens.
Para efeito de comparação, manter uma base de código de 300.000 tokens acessada por cinco agentes simultâneos em um ciclo de 10 iterações custaria mais de US$ 15 em modelos de fronteira sem cache agressivo. Com o cache persistido do Carbon, esse mesmo ciclo tem seu custo de entrada reduzido para menos de US$ 1,50. Para comparar quando vale pagar pela camada de coordenação mais cara e como esse equilíbrio muda após o reajuste de dezembro, veja a análise Claude Fable 5.2 vs Gemini 4 Carbon no enxame.
Essa eficiência no consumo de tokens também reflete a pressão física que a indústria de semicondutores enfrenta nos data centers: quanto mais tokens uma infraestrutura consegue servir por watt gasto, menor a dependência de megaclusters energéticos, como abordado em O muro elétrico da IA e na divisão de cargas entre NPU local e nuvem.
O que isso muda na rotina de quem constrói software
O surgimento de modelos nativos para enxames encerra a fase do “prompt engineering solitário” para problemas complexos de engenharia. O papel do desenvolvedor sênior evolui de quem digita código linha a linha ou debate em um chat para o de um arquiteto de sistemas agênticos:
- Definição de contratos claros: O modelo executa melhor quando recebe contratos determinísticos (schemas Zod, interfaces TypeScript e especificações OpenAPI) que funcionam como barreiras fail-closed.
- Delegação particionada: Em vez de pedir “crie um sistema completo”, a estratégia vencedora divide o trabalho em workspaces paralelos (ex.: lógica de negócio, testes de acessibilidade e camada de dados).
- Auditoria cruzada obrigatória: Agentes criados com personas distintas (um implementador e um auditor rigoroso de segurança) avaliam o mesmo código antes que qualquer pull request seja aberto.
O Gemini 4 Carbon não elimina a necessidade de supervisão humana; ele eleva o nível da conversa. Quem continuar tratando a IA como um assistente de bate-papo perderá a maior alavanca de produtividade que a engenharia de software presenciou nesta década: a capacidade de liderar um enxame coordenado de engenheiros sintéticos com rigor, método e prova de bancada.
Fontes
- Comunicado oficial do Google sobre o lançamento do Gemini 4 Carbon e integração de orquestração agêntica — Google Blog, Gemini 4 Carbon announcement, verificado em 2026-11-11.
- Documentação técnica e benchmarks de engenharia do Gemini 4 Carbon — Google DeepMind, Gemini Models, verificado em 2026-11-11.
- Tabela oficial de preços de tokens, suporte a thinking levels e política de desconto de prompt caching — Google AI Studio, Gemini API Pricing, verificado em 2026-11-11.
- Métricas consolidadas de desempenho em engenharia de software e testes multiagente — Artificial Analysis, Intelligence Index & CursorBench, dados compilados em 2026-11-11.