llm
12 posts publicadosPosts sobre llm
Chip próprio virou padrão: Iris da Meta e o acordo Qualcomm-Amazon
Por que Meta, Amazon e Qualcomm trocam Nvidia por silício próprio: custo, energia e independência nos data centers de IA.
O muro elétrico da IA: por que os data centers querem usinas nucleares
Entenda por que o avanço dos modelos de IA esbarrou na capacidade da rede elétrica e levou gigantes de tecnologia a fecharem contratos com usinas nucleares.
A virada do pensar: o que os modelos de fronteira mudam no trabalho
Entenda a mudanca para o raciocinio em tempo de inferencia nos novos modelos de fronteira e o que a reflexao das IAs exige de quem trabalha com elas.
Harness de agente: os gates que barraram erro real neste blog
Agente é modelo mais harness. A camada que decide a qualidade é a verificação — os gates que já barraram erro real aqui, e os que nenhum gate pega.
O que custa um ciclo multiagente: 6,67 milhões de tokens
Abri a conta de um ciclo de agentes de IA, rodada por rodada: onde os tokens foram, o que o gate barato economizou e por que a conta em dólar é um intervalo.
n8n como servidor MCP: quando o agente chama seu workflow sozinho
Expor workflows como ferramentas de IA inverte quem aperta o botão. O que muda na prática, o que a especificação do MCP proíbe e o que conferir antes de ligar.
Programar com IA: as práticas que separam ajuda de estrago
Assistente de IA acelera quem programa e amplia o estrago de quem não confere. As práticas reais: teste executado, contrato que trava e gate humano.
Memória de projeto para IA: como não recomeçar do zero a cada sessão
Assistentes de IA esquecem o projeto quando a sessão acaba. Um arquivo Markdown versionado devolve o contexto: o que registrar, o que descartar e por quê.
Por que agentes de IA quebram fora do laboratório
Modelos de ponta resolvem menos de 25% das tarefas profissionais reais. O gargalo não é inteligência: é ambiguidade, contexto e rastro — e dá para tratar.
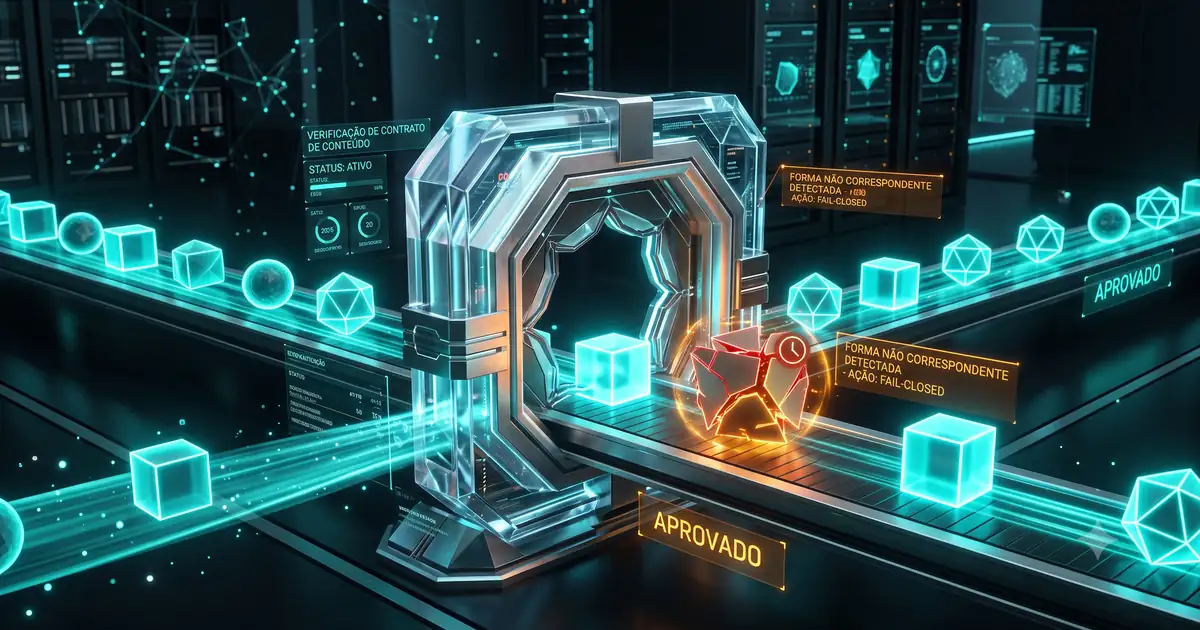
Contrato de conteúdo: onde o pipeline de IA pode errar sem publicar
Schema Zod como API entre o LLM e o repositório: taxonomia fechada, limites de SEO e build que falha antes do erro chegar à produção — com caso real.
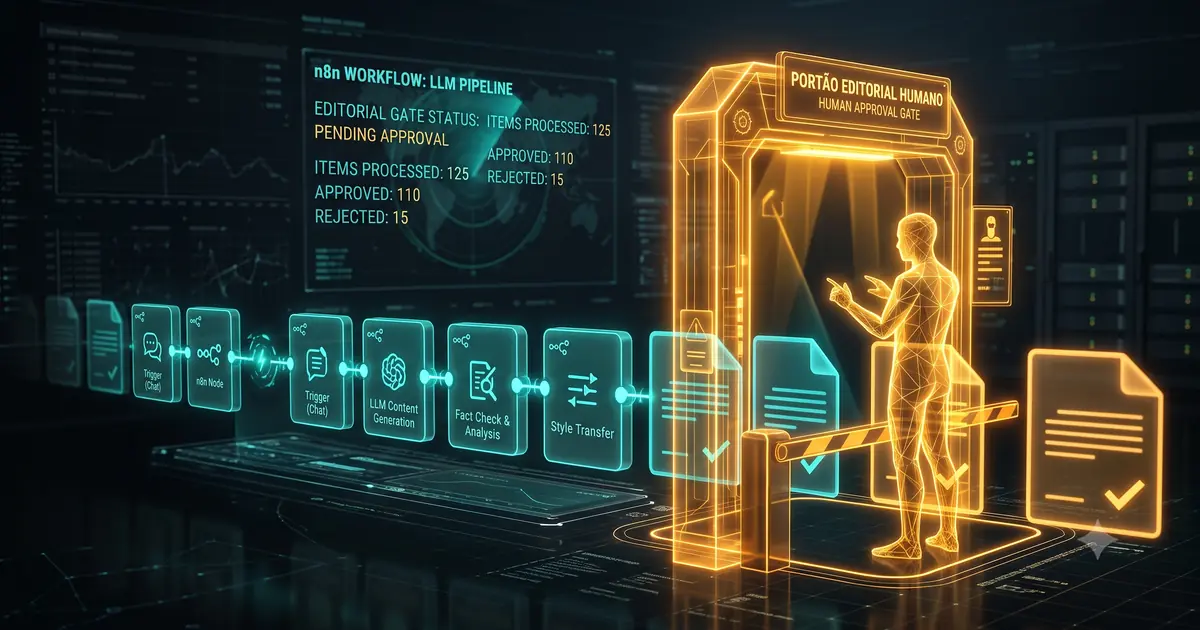
N8N + LLM: pipeline editorial com gate humano obrigatório
Registro real de arquitetura: por que cadência de 2 a 4 posts por semana e gate humano evitam penalização por conteúdo em escala.
Scaled content abuse: o que o Google Search realmente pune
Não é usar IA que o Google penaliza: é publicar conteúdo em escala sem valor real para o leitor. A política, com vigência e fonte oficial.