Na nossa análise de 11 de novembro de 2026 sobre o Gemini 4 Carbon para enxames de agentes, simulamos como a coordenação paralela tende a superar o modelo único em ciclos longos de engenharia. O outro lado da comparação chegou um dia antes da disponibilidade ampla do Carbon: em 9 de novembro de 2026, a Anthropic lançou o Claude Fable 5.2 (claude-fable-5-2) junto com sua contraparte restrita de defesa cibernética e ciências da vida, o Claude Mythos 5.2. Na tabela de entrada e saída de novembro, o Fable 5.2 custa quatro vezes mais que a tarifa promocional do Carbon (US$ 8,00 / US$ 40,00 contra US$ 2,00 / US$ 10,00 por milhão de tokens).
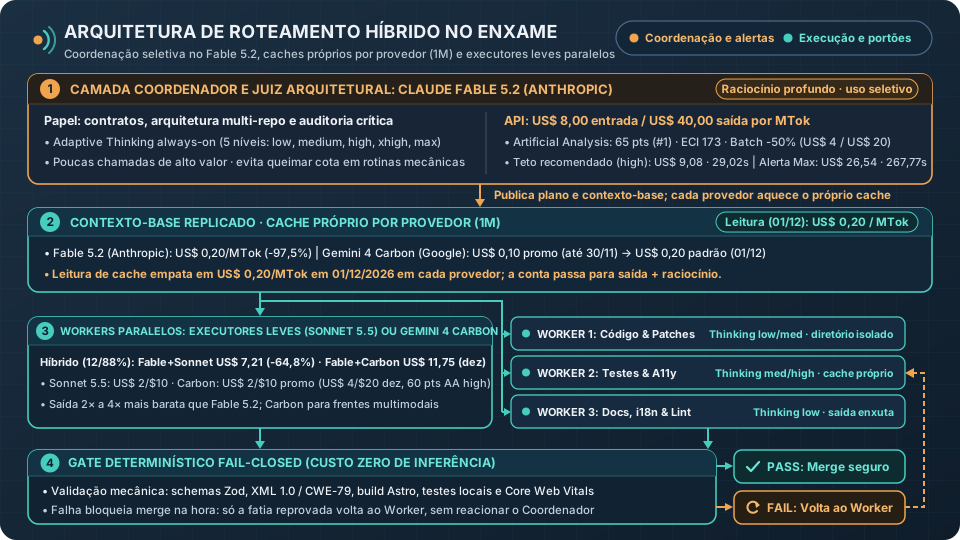
Resumo direto: quando vigência promocional, leitura em cache e esforço obrigatório entram na conta, três pontos definem o roteamento:
- Empate na leitura em cache em 1º de dezembro de 2026: ao encerrar a promoção do Carbon, ler contexto em cache passa a custar US$ 0,20 por milhão de tokens nos dois provedores, cada qual em seu cache próprio.
- Esforço máximo quase triplica a fatura por tarefa: na Artificial Analysis, subir de
highparamaxno Fable 5.2 adiciona 3 pontos no índice (62 para 65), mas eleva o custo médio de US$ 9,08 para US$ 26,54 e estica a espera até a primeira palavra útil de 29,02 s para 267,77 s. - Onde o enxame realmente economiza: a topologia de menor custo raramente usa o modelo mais caro em 100% das chamadas; ela concentra o Fable 5.2 em planejamento e revisão crítica e delega o volume paralelo a modelos leves com tarifa fixa (como Sonnet 5.5, -64,8% na projeção pós-dezembro), reservando o Carbon nos executores para cenários multimodais ou na janela promocional.
Este artigo é um estudo comparativo estruturado sobre documentação primária, tabelas contratuais vigentes e medições independentes verificadas em 12 de novembro de 2026. Não executamos bancada própria no Claude Fable 5.2; toda simulação econômica a seguir aplica fórmulas reproduzíveis sobre os contratos públicos das APIs e sobre os volumes globais de referência publicados no histórico do Fluxonar, com premissas analíticas declaradas antes de cada cálculo.
O cruzamento entre calendário de preços, isolamento de cache por provedor e multiplicador de tokens de saída explica por que a tabela nominal engana na escolha do enxame.
O que muda na ficha técnica e onde a tabela engana
A Anthropic apresentou o Claude Fable 5.2 com corte de 20% na tarifa padrão em relação ao Fable 5.1 (US$ 10 / US$ 50 para US$ 8 / US$ 40), janela de 1 milhão de tokens, limite de saída de 128 mil tokens e corte de conhecimento em junho de 2026. Assim como documentamos na análise sobre corte nominal de preço e impacto real no tokenizador, porém, a redução na tarifa por unidade não garante queda equivalente na fatura por tarefa.
No Fable 5.2, o raciocínio adaptativo (Adaptive Thinking) é permanente e não pode ser desligado via API. O desenvolvedor apenas orienta a profundidade por meio do parâmetro effort, distribuído em cinco degraus (low, medium, high, xhigh e max), com padrão high na API e medium no Claude Code e nos aplicativos da Anthropic. Chamadas que forçam seleção rígida de ferramentas (tool_choice do tipo any ou tool) ou parâmetros de amostragem como temperature, top_p e top_k retornam erro HTTP 400, exigindo adaptação de fluxos que antes travavam determinismo no nível da chamada HTTP.
| Dimensão técnica ou comercial | Claude Fable 5.2 (Anthropic) | Gemini 4 Carbon (Google DeepMind) |
|---|---|---|
| Lançamento geral | 2026-11-09 (junto ao Mythos 5.2 restrito) | Preview Fairwind em 2026-10-28; GA em 2026-11-10 |
| Janela / Saída máxima | 1M tokens entrada / 128K tokens saída | 1M tokens entrada; multimodal (texto, imagem, áudio e vídeo) |
| Controle de raciocínio | Adaptive Thinking sempre ativo (low a max) | Thinking Levels explícitos (low, medium, high) |
| Entrada / Saída padrão (MTok) | US$ 8,00 / US$ 40,00 | US$ 2,00 / US$ 10,00 até 30/11; US$ 4,00 / US$ 20,00 em 01/12 |
| Leitura em cache (MTok) | US$ 0,20 (97,5% off) com cache explícito pago na escrita | US$ 0,10 até 30/11; US$ 0,20 em 01/12 (95% off, apenas implícito) |
| Escrita em cache (MTok) | US$ 10,00 (TTL 5 min) ou US$ 16,00 (TTL 1 h) | Sem cobrança explícita de escrita (cache implícito automático) |
| Batch e aceleração | Batch -50% (US$ 4 / US$ 20); Fast Mode US$ 16 / US$ 80 (2x) | Batch -50% (US$ 1 / US$ 5 até 30/11; US$ 2 / US$ 10 em 01/12) |
| Artificial Analysis Index (indep.) | 65 (max) e 62 (high) | 60 (high) |
| Epoch Capabilities Index (indep.) | 173 (#1 de 240 modelos) | 170 (#2) |
| Disponibilidade imediata (GA) | Claude API, Bedrock, Vertex AI e Microsoft Foundry | Google Gemini API / AI Studio (sem nível gratuito) |
Há um detalhe contratual na documentação oficial do Google AI Studio que passa despercebido em comparativos superficiais: no Gemini 4 Carbon, o cache de contexto funciona exclusivamente no modo implícito, sem suporte a escrita e fixação explícita por TTL. No Claude Fable 5.2, a Anthropic cobra pela gravação explícita (US$ 10,00/MTok para 5 minutos ou US$ 16,00/MTok para 1 hora), mas oferece leitura determinística garantida a US$ 0,20/MTok, um desconto de 97,5% sobre a entrada padrão. Para enxames com dezenas de subagentes lendo o mesmo repositório ou especificação contratual dentro de uma janela fixa, o controle explícito de prefixo reduz o risco de perder acertos de cache por variação na ordem dos cabeçalhos.
A matemática do cache em dezembro e a conta no enxame
A primeira distorção econômica aparece quando se observa o calendário da própria documentação do Google. Os preços promocionais de US$ 2,00 na entrada, US$ 10,00 na saída e US$ 0,10 no cache do Gemini 4 Carbon valem somente até 30 de novembro de 2026. A partir de 1º de dezembro de 2026, a tabela padrão passa para US$ 4,00 na entrada, US$ 20,00 na saída e US$ 0,20 na leitura em cache.
Nesse ponto exato, a vantagem unitária do Carbon na leitura repetida de contexto desaparece. O cache de prompt permanece isolado por provedor e por modelo: quando um enxame combina fornecedores distintos, cada modelo mantém seu cache próprio e paga separadamente pelo aquecimento do contexto-base replicado, sem memória compartilhada entre Anthropic e Google. O empate em US$ 0,20 por milhão de tokens a partir de dezembro ocorre estritamente na tarifa de leitura dentro de cada ecossistema.
Toda a diferença financeira remanescente passa a depender de três variáveis: o custo de gravar o contexto no Fable 5.2 (US$ 10/MTok na escrita explícita de 5 minutos contra cache apenas implícito no Carbon), a entrada não reutilizada (US$ 8 contra US$ 4) e, principalmente, os tokens de saída somados aos tokens internos de raciocínio (US$ 40/MTok contra US$ 20/MTok, já que ambos cobram raciocínio na tarifa de saída).
Para verificar o impacto prático, partimos dos envelopes totais dos dois exercícios publicados no blog, adotando premissas analíticas explícitas para comparar os modelos de forma uniforme. No primeiro caso, usamos o cenário de 300.000 tokens de código, 5 agentes e 10 iterações apresentado no post de lançamento do Carbon em 11 de novembro de 2026. Como aquele artigo registrava apenas o tamanho da base e o efeito das leituras repetidas sem detalhar cada turno, assumimos aqui uma quebra uniforme de 50 chamadas: 300 mil tokens iniciais gravados uma vez, 14,7 milhões de tokens lidos em acerto de cache, 25 mil tokens novos de instrução ao longo das iterações e 100 mil tokens totais de saída com raciocínio moderado.
- Gemini 4 Carbon em novembro (US$ 2 / US$ 10 / cache US$ 0,10): assumindo acerto implícito integral nos 14,7M tokens lidos, a conta fecha em
(0,325 × 2,00) + (14,7 × 0,10) + (0,100 × 10,00)= US$ 3,12. Na publicação de 11 de novembro, o valor citado abaixo de US$ 1,50 coincide com o bloco isolado de leituras em cache (14,7M a US$ 0,10/MTok = US$ 1,47); ao somar a entrada inicial não cacheada (US$ 0,65, totalizando US$ 2,12 de entrada) e a saída (US$ 1,00), a conta completa fecha em US$ 3,12. - Gemini 4 Carbon a partir de dezembro (US$ 4 / US$ 20 / cache US$ 0,20): sob essas mesmas premissas, a fatura dobra para
(0,325 × 4,00) + (14,7 × 0,20) + (0,100 × 20,00)= US$ 6,24. - Claude Fable 5.2 (US$ 8 / US$ 40 / escrita 5m US$ 10 / leitura US$ 0,20): gravação explícita de 0,300M (US$ 3,00) + 0,025M novos (US$ 0,20) + 14,7M de leitura (US$ 2,94) + 0,100M de saída (US$ 4,00) = US$ 10,14. Sob a premissa controlada de mesmo volume de saída, se o nível de esforço elevar a deliberação de 100 mil para 500 mil tokens, o custo do Fable 5.2 sobe para US$ 26,14, contra US$ 14,24 no Carbon em dezembro.
No segundo exercício, projetamos as tarifas sobre o envelope total de 6,67 milhões de tokens registrado em nosso ciclo multiagente real. Como aquela auditoria mediu apenas o total agregado do ciclo sem gravar a partição interna por chamada, adotamos como premissa ilustrativa uma distribuição com forte reuso de contexto (5,80M de tokens em leitura de cache, 0,50M entre entrada nova e aquecimento ponderado a US$ 9,00/MTok no Fable, e 0,37M em saída com raciocínio) e uma divisão ilustrativa de 12% na coordenação e 88% na execução paralela. O volume de saída é mantido idêntico por construção; caso o Carbon repetisse a verbosidade 2,4× maior medida no índice da Artificial Analysis (cerca de 0,888M de saída), sua fatura pós-dezembro subiria para cerca de US$ 20,92 (US$ 1,16 + US$ 2,00 + US$ 17,76), praticamente empatando com o Fable puro (US$ 20,46):
| Topologia sobre ciclo ilustrativo de 6,67M tokens | Cache e entrada nova | Saída + raciocínio | Custo total estimado |
|---|---|---|---|
| Enxame 100% Claude Fable 5.2 | US$ 1,16 cache + US$ 4,50 nova/escrita | 0,37M × US$ 40,00 = US$ 14,80 | US$ 20,46 (US$ 35,26 se saída dobrar) |
| Enxame 100% Gemini 4 Carbon (pós-01/12) | US$ 1,16 cache + US$ 2,00 nova | 0,37M × US$ 20,00 = US$ 7,40 | US$ 10,56 (US$ 5,28 até 30/11) |
| Híbrido de custo (12% Fable 5.2 + 88% Sonnet 5.5) | Fable US$ 0,68 + Sonnet US$ 1,50 | Fable US$ 1,78 + Sonnet US$ 3,26 | US$ 7,21 (-64,8% vs. Fable puro) |
| Híbrido multi-provedor (12% Fable 5.2 + 88% Carbon) | Fable US$ 0,68 + Carbon US$ 2,78 | Fable US$ 1,78 + Carbon US$ 6,51 | US$ 11,75 pós-01/12 (US$ 7,10 em nov.) |
A divisão ilustra os padrões Orchestrator (que decompõe e delega) e Advisor (consultado quando um modelo menor trava), alocando 12% do ciclo ao Fable 5.2 (0,696M em cache, 0,060M de entrada/escrita a US$ 9,00/MTok e 0,0444M de saída = US$ 2,46) e os 88% restantes ao modelo executor:
- Rota de menor custo pós-dezembro (12% Fable 5.2 + 88% Claude Sonnet 5.5): aplicando por premissa simétrica de escrita de 5 minutos as tarifas do Sonnet 5.5 (5,104M em cache a US$ 0,10/MTok, 0,440M ponderados a US$ 2,25/MTok entre US$ 2,00 e US$ 2,50, e 0,3256M de saída a US$ 10,00/MTok = US$ 4,76), a soma sem arredondamento intermediário fecha em US$ 7,21, corte de 64,8% (cerca de 65%) frente ao enxame todo em Fable 5.2. O ganho se preserva após dezembro porque a tarifa do Sonnet 5.5 não sofre reajuste em 1º de dezembro.
- Rota multi-provedor com Gemini 4 Carbon (12% Fable 5.2 + 88% Carbon, chamadas síncronas): até 30 de novembro na tarifa promocional (US$ 2 / US$ 10), os 88% em Carbon fecham em US$ 4,65 e o par híbrido soma US$ 7,10; a partir de 1º de dezembro (US$ 4 / US$ 20), a fatia do Carbon sobe para US$ 9,29 e o total chega a US$ 11,75, acima dos US$ 10,56 do Carbon puro síncrono.
- Quando o par com Carbon se justifica e o impacto da Batch API: na comparação simétrica, esse híbrido multi-provedor justifica-se por resiliência multi-cloud, multimodalidade nativa ou teto superior de raciocínio no coordenador, não por economia bruta. Com os 88% na Batch API do Carbon (US$ 2 / US$ 10 e leitura de cache a US$ 0,10 após 1º de dezembro, conforme a aba Batch do Google AI Studio), a parcela cai para US$ 4,65 e o par soma US$ 7,10: abaixo do Carbon puro síncrono (US$ 10,56), mas acima do Carbon puro também em Batch (US$ 5,28).
Os 5 níveis de esforço, latência real e o risco no nível máximo
Os números por milhão de tokens ainda deixam de fora a variável operacional que mais tem surpreendido desenvolvedores desde 9 de novembro: a explosão de deliberação interna conforme sobe o parâmetro effort. Os cinco níveis do Fable 5.2 não são um teto rígido de tokens. Conforme a documentação oficial de API ressalta, effort atua apenas como sinal comportamental, o que significa que o modelo continua gastando o quanto julgar necessário em problemas complexos mesmo quando configurado abaixo do máximo.
As medições independentes publicadas pela Artificial Analysis (versão v5.0.1 do Intelligence Index, verificadas em 12 de novembro de 2026) expõem com precisão o custo marginal de cada degrau frente ao Gemini 4 Carbon em nível high:
| Configuração medida (Artificial Analysis v5.0.1) | Intelligence Index | Tempo até 1º token de resposta | Vazão de saída | Tempo por tarefa | Custo médio por tarefa | Tokens de saída no índice |
|---|---|---|---|---|---|---|
Claude Fable 5.2 (low) | 54 (#15) | 8,45 s | 98 tok/s | 6,1 min | US$ 3,10 | 34,9M |
Claude Fable 5.2 (medium) | 56 (#9) | 11,67 s | 95 tok/s | 7,6 min | US$ 3,80 | 41M |
Claude Fable 5.2 (high, padrão API) | 62 (#3) | 29,02 s | 97 tok/s | 16,9 min | US$ 9,08 | 85,3M |
Claude Fable 5.2 (xhigh) | 62 (#2) | 87,90 s | 103 tok/s | 26,2 min | US$ 14,83 | 144M |
Claude Fable 5.2 (max) | 65 (#1) | 267,77 s | 98 tok/s | 46,8 min | US$ 26,54 | 275M |
Gemini 4 Carbon (high) | 60 (#4) | 67,62 s | 75 tok/s | 27,4 min | US$ 5,48 | 205M |
Um cuidado conceitual é obrigatório ao ler a terceira coluna. Os 267,77 segundos (quase quatro minutos e meio) medidos no Fable 5.2 em max representam o tempo até o primeiro token de resposta (Time to First Answer Token) após o bloco silencioso de raciocínio interno, e não latência inicial de rede até o primeiro pacote HTTP. Enquanto a vazão após começar a escrever permanece rápida e constante (95 a 103 tok/s, contra 75 tok/s do Carbon), o modelo em max passa minutos deliberando antes de emitir a primeira palavra útil ao usuário ou ao próximo agente do grafo.
A curva de retorno decrescente explica por que high (62 pontos, 29,02 s, US$ 9,08) e xhigh (62 pontos, 87,90 s, US$ 14,83) costumam ser o teto racional para quase toda engenharia comercial. Subir de high para max rende apenas 3 pontos extras no índice agregado (62 para 65), mas multiplica o custo médio por tarefa por 2,92× (de US$ 9,08 para US$ 26,54) e aumenta em 9,2× a espera pelo primeiro token visível. Em rotinas não interativas, usar a Batch API reduz entrada e saída pela metade (US$ 4,00 / US$ 20,00), enquanto o Fast Mode cobra exatamente o dobro (US$ 16,00 / US$ 80,00) para entregar até 2,5× mais tokens por segundo em gargalos onde um engenheiro aguarda em tela.
Na prática de orquestração, deixar subagentes operarem em max sem restrição de gasto amplifica a verbosidade observada na medição independente (275 milhões de tokens de saída no índice da Artificial Analysis contra mediana de 72,8 milhões entre modelos comparáveis) e aumenta o risco de alterações mais amplas do que a tarefa exige. Como effort não impõe limite rígido de orçamento, conter desvios exige o mesmo desenho descrito no artigo sobre portões determinísticos no arcabouço de controle de agentes: bloqueio estrito de diretórios permitidos por tarefa, tetos explícitos de max_tokens e validação automática em esquema em que a falha fecha a porta antes de aceitar qualquer alteração no repositório.
Assimetria dos benchmarks e o que a régua independente confirma
Uma comparação honesta precisa registrar o descompasso metodológico entre o material de lançamento publicado pelo Google e os números divulgados pela Anthropic em 9 de novembro. Na análise de 11 de novembro de 2026 sobre o Gemini 4 Carbon, os destaques do Google focavam SWE-bench Verified (52,8%), CursorBench (78,4%) e Zapier AutomationBench (86,2%). A Anthropic, por sua vez, priorizou uma safra diferente de suítes de avaliação em seu anúncio oficial.
Segundo os números reportados pela própria Anthropic na ficha de lançamento (2026-11-09), o Claude Fable 5.2 alcançou 69,9% no FrontierSWE v2 (contra 61,2% atribuídos ao Carbon e 62,3% ao Opus 5.5), 89,3% no OSWorld 2.1 (contra 81,5% do Carbon) e 74,6% no Terminal-Bench-Science 0.1 (75,3% no Mythos 5.2, contra 64,8% do Carbon). No FrontierCode 2.0, a própria tabela da fornecedora registra uma diferença importante de protocolo: o Fable 5.2 atingiu 49,1% avaliado em Xhigh effort, enquanto o Gemini 4 Carbon aparece listado com 41,1% em Medium effort. Já em fluxos corporativos do AutomationBench, o próprio quadro da Anthropic mostra o Gemini 4 Carbon ligeiramente à frente (53,9% contra 51,4% do Fable 5.2).
Sem uma bateria independente única que rode todas as seis suítes sob o mesmo orçamento de tokens e o mesmo nível de esforço, números de fornecedor servem apenas como sinal direcional. Quando voltamos às duas réguas independentes comuns verificadas em 12 de novembro de 2026, o quadro fica mais limpo e menos extremo: no Epoch AI ECI, o Fable 5.2 lidera entre 240 modelos com 173 pontos (#1) contra 170 pontos do Gemini 4 Carbon (#2); na Artificial Analysis v5.0.1, o Fable 5.2 marca 65 em max (#1) e 62 em high (#3) contra 60 do Carbon (#4), com o Carbon medido em US$ 5,48 por tarefa (tendo a tabela de novembro de US$ 2 / US$ 10 listada ao lado na página da análise) frente aos US$ 9,08 do Fable 5.2 em high. Permanece ainda como lacuna pública não divulgada por nenhuma das duas empresas a contagem de parâmetros, o desenho interno (denso ou mistura de especialistas) e o volume computacional exato de treinamento.
A conta se inverte no ponto de equilíbrio pós-1º de dezembro de 2026. Como a tarifa de leitura em cache empata em US$ 0,20/MTok (anulando esse termo) e a escrita explícita de 5 minutos no Fable 5.2 custa US$ 10/MTok contra US$ 4/MTok na entrada inicial equivalente do Carbon (diferença líquida de US$ 6/MTok), a diferença de custo em dólares reduz-se a Δ = 4·M_nova + 6·M_escrita + 20·M_saída, em que cada M representa milhões de tokens (respectivamente de entrada nova, escrita explícita em cache de 5 minutos e saída). Quando a saída domina a fatura, como na bateria da Artificial Analysis, e os volumes de entrada são equivalentes, o Fable 5.2 empata o gasto sempre que entrega a mesma tarefa consumindo cerca de metade dos tokens de saída do Carbon. Na própria bateria da Artificial Analysis v5.0.1, o Carbon emitiu 205 milhões de tokens de saída, ou 2,4× os 85,3 milhões gastos pelo Fable 5.2 em high; como estimativa assumindo escala linear com a tabela padrão de dezembro (US$ 4 / US$ 20), o custo calculado do Carbon por tarefa dobra para cerca de US$ 10,96, acima dos US$ 9,08 do Fable 5.2 em high.
Disponibilidade multi-cloud, retenção (ZDR) e a bifurcação Fable vs. Mythos
Do ponto de vista de compras corporativas e infraestrutura, a principal vantagem imediata do Claude Fable 5.2 em novembro de 2026 não é um ponto percentual isolado de benchmark, e sim a distribuição ampla desde o primeiro dia. O modelo estreou em disponibilidade geral na API direta da Anthropic, no Amazon Bedrock (global.anthropic.claude-fable-5-2), no Google Cloud Vertex AI (em oferta gerenciada pelo Google e pela própria Anthropic) e no Microsoft Foundry. Enquanto o Gemini 4 Carbon concentra seu acesso documentado de API na camada paga do Google (Google AI Studio / Gemini API, sem nível gratuito), times que já operam sobre nuvem AWS ou Azure conseguem provisionar o Fable 5.2 hoje no Bedrock e no Microsoft Foundry sob o mesmo contrato corporativo.
Essa estreia lembra o programa fechado Fairwind do Google, citado em 11 de novembro de 2026, no qual o Carbon foi desenvolvido para cibersegurança; no caso da Anthropic, a separação comercial de exatamente os mesmos pesos neurais em dois regimes de salvaguarda está documentada no anúncio oficial e no system card. A Anthropic lançou o Claude Fable 5.2 para o mercado geral com classificadores em camadas, sondas de ativação, proteções reforçadas contra ataques de destilação (incluindo retenção obrigatória do bloco de pensamento para impedir edição retroativa no histórico) e desvio transparente para modelos anteriores (Opus 4.8 em cibersegurança ofensiva e Opus 5 em biologia) quando uma consulta dispara bloqueio de risco. Em paralelo, o Claude Mythos 5.2 entrega os mesmos pesos e tarifas sem esses bloqueios especializados, restrito a organizações aprovadas nos programas Cyber Verification Program e Life Sciences Verification Program.
Para times de arquitetura e segurança corporativa, a letra miúda mais sensível está na política de retenção de dados documentada pela Anthropic. Por padrão, para qualquer conta sem exceção ZDR aprovada ou adesão ao Enterprise Frontier Safeguards, o claude-fable-5-2 exige retenção de 30 dias para monitoramento de padrões de uso abusivo e não é elegível ao modo Zero Data Retention (ZDR) (o Enterprise Frontier Safeguards atua em beta privado com classificadores automatizados sobre registros armazenados dentro da própria infraestrutura do cliente). Antes de apontar um agente corporativo ou editor de código com modo estrito de privacidade para o novo identificador na API, administradores precisam validar se a conta possui exceção contratual de ZDR ativa.
Matriz de decisão para arquiteturas em produção
A escolha entre os dois modelos não depende de qual lidera por três pontos um ranking geral, mas de qual gargalo limita sua operação atual:
- O Claude Fable 5.2 (
highouxhigh) cabe como coordenador ou revisor quando a operação exige disponibilidade imediata em Bedrock, Vertex ou Foundry, controle explícito de escrita em cache com leitura a US$ 0,20/MTok e teto máximo de raciocínio em refatorações multi-repositório ou decisões arquiteturais de alto impacto. - O Claude Sonnet 5.5 (US$ 2 / US$ 10) atua como candidato a executor padrão (com leitura de cache documentada a US$ 0,10/MTok), sujeito a validar capacidade na sua carga após 1º de dezembro (US$ 7,21 na simulação ilustrativa híbrida, mantendo o mesmo ecossistema da Anthropic), enquanto o Gemini 4 Carbon (
mediumouhigh) atende bem frentes multimodais e de hardening de segurança na camada paga do Google AI Studio / Gemini API, aproveitando o menor preço promocional até novembro ou o desempenho no AutomationBench (53,9% na tabela da concorrente). - O nível
maxe chamadas ao Fable 5.2 ficam fora de tarefas mecânicas repetitivas sem portões automáticos de escopo. Em fluxos simples, modelos intermediários como Opus 5.5 (US$ 4 / US$ 20), Sonnet 5.5 (US$ 2 / US$ 10) ou Haiku 5.5 (US$ 0,10 / US$ 0,50 abaixo de 100 mil tokens) resolvem sem pagar a espera superior a quatro minutos de deliberação prévia.
Em enxames multi-provedor com Fable 5.2 e Carbon, a superfície de dados se divide entre dois processadores externos (Anthropic e camada paga do Google), exigindo validação de retenção e ZDR nos dois contratos. Além disso, como tool_choice forçado retorna erro HTTP 400 no Fable 5.2, os portões determinísticos precisam validar saída estruturada por esquema após a resposta em vez de depender de travamento forçado de ferramenta na chamada HTTP.
Em enxames de produção, o modelo de fronteira mais caro não substitui os modelos menores; ele justifica seu preço justamente quando pensa poucas vezes no topo do grafo para que dezenas de execuções mais baratas não errem em escala.
Fontes
- Claude Platform Docs — Claude Fable 5.2 Overview & Effort (
2026-11-09, verificado em2026-11-12): especificações de contexto (1M), saída (128K), níveis deeffortcomo sinal comportamental, erro400em amostragem/tool choice forçado, retenção padrão de 30 dias, restrição de ZDR e IDs multi-cloud. platform.claude.com/docs/en/models/fable-5-2/overview e platform.claude.com/docs/en/build-with-claude/effort - Claude Platform Docs — Pricing (
2026-11-09, verificado em2026-11-12): tabela contratual de entrada/saída, escrita e leitura de Prompt Caching, Batch API (50%off) e Fast Mode para Fable 5.2, Opus 5.5, Sonnet 5.5 e Haiku 5.5. platform.claude.com/docs/en/about-claude/pricing - Anthropic — Introducing Claude Fable 5.2 and Claude Mythos 5.2 (
2026-11-09, atualizado em2026-11-11, verificado em2026-11-12): anúncio oficial, benchmarks reportados pela fornecedora (FrontierCode 2.0,FrontierSWE v2,AutomationBench,OSWorld 2.1,Terminal-Bench-Science 0.1), papéis de Advisor e Orchestrator, fallback para Opus 4.8 / Opus 5, Enterprise Frontier Safeguards e programas de verificação do Mythos 5.2. anthropic.com/claude-fable-and-mythos-5-2 - Anthropic — Claude Fable 5.2 and Claude Mythos 5.2 System Card (
2026-11-09, verificado em2026-11-12): detalhamento técnico de salvaguardas, avaliações de segurança e alinhamento dos pesos compartilhados. anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card - AWS — Claude Fable 5.2 is now available on AWS (
2026-11-09, verificado em2026-11-12): confirmação de disponibilidade geral imediata no Amazon Bedrock (global.anthropic.claude-fable-5-2). aws.amazon.com/about-aws/whats-new/2026/11/claude-fable-5-2-aws/ - Google AI Studio — Gemini API Pricing: Gemini 4 Carbon (
2026-11-10, verificado em2026-11-12): vigência promocional até2026-11-30(US$ 2 / US$ 10e cacheUS$ 0,10), reajuste em2026-12-01(US$ 4 / US$ 20e cacheUS$ 0,20) e nota contratual de suporte exclusivo a cache implícito. aistudio.google.com/docs/pricing - Artificial Analysis — Claude Fable 5.2 (
max,xhigh,high,medium,low) & Gemini 4 Carbon (high) (2026-11-12): medições independentes de Intelligence Index v5.0.1, Time to First Answer Token, vazão de tokens, tempo e custo por tarefa. artificialanalysis.ai/models/claude-fable-5-2 e artificialanalysis.ai/models/gemini-4-carbon - Epoch AI — Claude Fable 5.2 & Gemini 4 Carbon (Epoch Capabilities Index) (
2026-11-09, verificado em2026-11-12): ranking independente ECI (173vs.170) e registro de ausência de divulgação pública para parâmetros e computação de treino. epoch.ai/models/claude-fable-5-2 e epoch.ai/models/gemini-4-carbon