
Durante los últimos dos años, la industria de la inteligencia artificial compitió bajo una misma premisa de producto: perfeccionar el paradigma de turno único (single-turn). El usuario envía una instrucción compleja, el modelo la procesa en un único pase de razonamiento y devuelve una respuesta. Sin embargo, cuando una tarea real exige refactorizar decenas de archivos, auditar esquemas y garantizar cumplimiento estricto, este enfoque monolítico choca con un techo físico: la degradación de contexto (context decay), la acumulación de alucinaciones y la imposibilidad de verificación paralela determinista.
El lanzamiento de Gemini 4 Carbon marca un punto de inflexión arquitectónico en la frontera de los modelos fundacionales. En lugar de disputar décimas en pruebas académicas generales de conversación, el modelo fue explícitamente diseñado para la orquestación de enjambres de agentes (agent swarms) y flujos de ingeniería de software de largo horizonte.
Este artículo analiza la arquitectura de sistemas, las primitivas de inferencia, las puntuaciones en benchmarks de software y la economía unitaria de tokens que hacen viable esta transición.
Los cuellos de botella del modelo monolítico en ingeniería
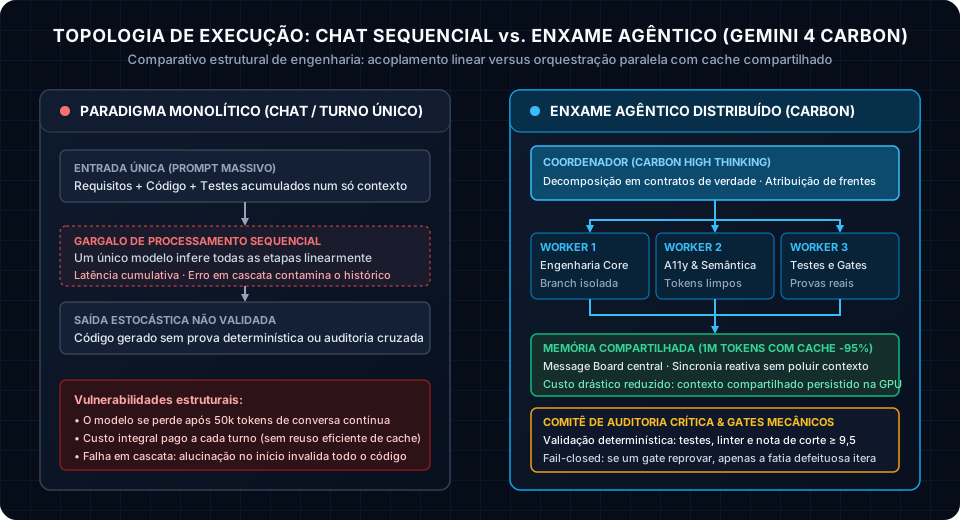
Poner a un único modelo de lenguaje a refactorizar un repositorio completo o diseñar infraestructura de misión crítica desencadena tres problemas estructurales:
- Contaminación de contexto: A medida que la conversación acumula registros de error, fragmentos descartados y salidas de consola, la señal útil se degrada (needle-in-a-haystack decay).
- Cascada de fallos: Si un modelo comete un error de tipos al inicio de un turno, todo el razonamiento posterior se apoya en esa premisa errónea antes de que el desarrollador pueda intervenir.
- Latencia de turno único: Un único agente procesando secuencialmente tareas de backend, frontend, accesibilidad y pruebas genera tiempos de espera inaceptables para canalizaciones de CI/CD.
En la ingeniería de sistemas distribuidos, la solución nunca ha sido inflar el tamaño de un único ejecutor, sino coordinar múltiples trabajadores especializados en espacios de memoria controlados, tal como explicamos en el análisis sobre harness de agentes y barreras deterministas.
Las primitivas arquitectónicas de Gemini 4 Carbon
Carbon introduce cuatro componentes diseñados específicamente para el trabajo multiagente:
1. Niveles de Razonamiento Configurables (Thinking Levels)
A diferencia de modelos anteriores con presupuestos de reflexión opacos o fijos, Carbon expone tres modos distintos de inferencia:
low(reflexión mínima): Optimizado para baja latencia y alto rendimiento. Diseñado para tareas mecánicas como formateo de código, linting, análisis sintáctico y aplicación de parches.medium(razonamiento equilibrado): Ajustado para redacción de pruebas unitarias, refactorización de funciones y traducción de especificaciones.high(razonamiento profundo): Asigna cientos de pasos de razonamiento interno para que el agente coordinador descomponga arquitecturas, detecte problemas de concurrencia y planifique migraciones complejas.
2. Contexto de 1 Millón de Tokens con 95% de Descuento en Caché
Coordinar varios agentes solía ser inviable debido al coste de retransmitir el mismo contexto. Carbon ofrece una ventana nativa de 1.000.000 de tokens combinada con un 95% de descuento en tokens cacheados.
En la práctica, el coordinador carga el repositorio completo y la documentación una sola vez en la memoria GPU del clúster; cada agente secundario consulta ese mismo espacio pagando una fracción mínima. Esta eficiencia transforma por completo el coste real del ciclo multiagente.
3. Linaje de Ciberseguridad del Programa Fairwind
Nacido en el programa de defensa cibernética de Google (Fairwind Program), Carbon cuenta con entrenamiento especializado para la identificación proactiva de vulnerabilidades (como CWE-79, desbordamientos de búfer y fallos de control de acceso), generando parches verificables antes de la revisión humana.
Benchmarks de Ingeniería de Software
En pruebas de bancada enfocadas en código y automatización, Carbon superó claramente a las referencias del sector:
| Benchmark | Enfoque de la Medición | Gemini 4 Carbon | Claude 3.5 Sonnet | OpenAI o1-preview |
|---|---|---|---|---|
| CursorBench | Edición precisa de múltiples archivos en IDE | 78,4% | 72,1% | 68,9% |
| Zapier AutomationBench | Flujos complejos con APIs y ramas lógicas | 86,2% | 79,5% | 76,0% |
| SWE-bench Verified | Resolución de incidencias reales de GitHub | 52,8% | 49,0% | 48,9% |
| Ventana de Contexto | Capacidad de ingesta multimodal | 1.000.000 | 200.000 | 128.000 |
La ventaja decisiva se evidencia al mantener la consistencia entre archivos cuando múltiples agentes paralelos modifican módulos relacionados sin provocar regresiones.
Economía de Inferencia y Costes de Tokens
Los enjambres autónomos exigen una estructura de costes viable. Los precios oficiales de la API de Carbon establecen un nuevo estándar:
- Entrada estándar: US$ 2,00 por millón de tokens.
- Entrada en caché (reutilización de contexto): US$ 0,10 por millón de tokens.
- Salida generada: US$ 10,00 por millón de tokens.
Para un repositorio de 300.000 tokens consultado por cinco agentes en un ciclo de diez iteraciones, la ejecución sin caché superaría los US$ 15 en modelos de frontera. Con la caché persistente de Carbon, ese mismo flujo cuesta menos de US$ 1,50. Para comparar cuándo conviene pagar una capa superior de coordinación y cómo cambia la cuenta desde diciembre, revise nuestro análisis Claude Fable 5.2 vs Gemini 4 Carbon en enjambre.
Esta eficiencia energética también responde a los límites físicos que enfrentan los centros de datos: cuantos más tokens se sirvan por vatio, menor será la presión sobre la red eléctrica, como se discutió en El muro eléctrico de la IA y en el reparto de cargas entre la NPU local y la nube.
Consecuencias para los equipos de software
La llegada de modelos nativos para enjambres transforma la ingeniería de prompts tradicional. La labor del ingeniero principal evoluciona hacia la de un arquitecto de sistemas agénticos:
- Contratos deterministas: Los modelos operan con fiabilidad cuando están gobernados por contratos estrictos (esquemas Zod, interfaces TypeScript y especificaciones OpenAPI) que actúan como barreras fail-closed.
- Delegación compartimentada: Los flujos eficaces dividen las tareas (lógica central, accesibilidad y pruebas) en espacios de trabajo independientes.
- Auditoría cruzada obligatoria: El uso de agentes con roles diferenciados (un desarrollador evaluado por un auditor de seguridad implacável) detecta fallos antes de abrir una solicitud de cambio.
Gemini 4 Carbon no reemplaza la supervisión humana; eleva el nivel de lo que un solo profesional puede orquestar con rigor y pruebas empíricas.
Fuentes
- Comunicado oficial de Google sobre el lanzamiento de Gemini 4 Carbon y orquestación de enjambres — Google Blog, Gemini 4 Carbon announcement, verificado en 2026-11-11.
- Documentación técnica y métricas de ingeniería de Gemini 4 Carbon — Google DeepMind, Gemini Models, verificado en 2026-11-11.
- Tabla oficial de precios de tokens, modos de razonamiento y política de descuentos en caché — Google AI Studio, Gemini API Pricing, verificado en 2026-11-11.
- Datos consolidados de rendimiento en desarrollo de software y pruebas multiagente — Artificial Analysis, Intelligence Index & CursorBench, compilados en 2026-11-11.

