
En nuestro análisis del 11 de noviembre de 2026 sobre Gemini 4 Carbon para enjambres de agentes, simulamos cómo la coordinación paralela tiende a superar al modelo único en ciclos largos de ingeniería. El otro lado de la comparativa llegó un día antes del despliegue amplio de Google: el 9 de noviembre de 2026, Anthropic lanzó Claude Fable 5.2 (claude-fable-5-2) junto con su variante restringida para defensa cibernética y ciencias de la vida, Claude Mythos 5.2. Al observar solo la tarifa nominal de noviembre, Fable 5.2 cuesta cuatro veces más que el precio promocional de Carbon (US$ 8,00 / US$ 40,00 frente a US$ 2,00 / US$ 10,00 por millón de tokens).
Resumen directo: al incorporar vigencia promocional, lectura en caché y razonamiento obligatorio, tres puntos definen el enrutamiento:
- Empate en lectura de caché el 1 de diciembre de 2026: cuando vence la promoción de Carbon, leer contexto reutilizado pasa a costar US$ 0,20 por millón de tokens en ambos proveedores, cada uno dentro de su propia caché.
- El esfuerzo máximo casi triplica la factura por tarea: en las mediciones de Artificial Analysis, subir de
highamaxen Fable 5.2 suma 3 puntos en el índice (62 a 65), pero eleva el costo medio de US$ 9,08 a US$ 26,54 y alarga la espera hasta la primera palabra útil de 29,02 s a 267,77 s. - Dónde ahorra realmente el enjambre: la topología más económica rara vez coloca el modelo más costoso en el 100% de las llamadas; reserva Fable 5.2 para planificación y revisión crítica y delega el trabajo paralelo en modelos ligeros de tarifa fija (como Sonnet 5.5, -64,8% después de diciembre), dejando Carbon como ejecutor ante requisitos multimodales o en la ventana promocional.
Este artículo es un estudio comparativo basado en documentación primaria, tarifas contractuales vigentes y mediciones independientes verificadas el 12 de noviembre de 2026. No ejecutamos benchmarks propios sobre Claude Fable 5.2; toda proyección económica siguiente utiliza fórmulas reproducibles aplicadas sobre los contratos públicos de las API y sobre los volúmenes agregados publicados en nuestro archivo técnico, con supuestos analíticos declarados antes de cada cálculo.
Cruzar calendario tarifario, aislamiento de caché por proveedor y multiplicador de salida explica por qué la tabla nominal induce a error.
Qué cambia en la ficha técnica y dónde engaña la tarifa
Anthropic presentó Claude Fable 5.2 con un recorte del 20% frente a la tarifa estándar de Fable 5.1 (US$ 10 / US$ 50 a US$ 8 / US$ 40), ventana de 1 millón de tokens, límite de salida de 128 mil tokens y corte de conocimiento en junio de 2026. Sin embargo, tal como documentamos al analizar los recortes nominales frente al peso real del tokenizador, un precio unitario menor no garantiza una factura proporcionalmente más baja por tarea.
En Fable 5.2, el razonamiento adaptativo (Adaptive Thinking) permanece siempre activo y no puede desactivarse por API. El desarrollador solo orienta la profundidad mediante el parámetro effort en cinco niveles (low, medium, high, xhigh y max), con high por defecto en la API y medium en Claude Code y las aplicaciones de Anthropic. Además, las peticiones que fuerzan selección estricta de herramientas (tool_choice tipo any o tool) o parámetros de muestreo como temperature, top_p y top_k devuelven un error HTTP 400, lo que obliga a ajustar flujos heredados que fijaban determinismo desde la llamada HTTP.
| Dimensión técnica o comercial | Claude Fable 5.2 (Anthropic) | Gemini 4 Carbon (Google DeepMind) |
|---|---|---|
| Lanzamiento general | 2026-11-09 (junto con Mythos 5.2 restringido) | Vista previa Fairwind 2026-10-28; GA 2026-11-10 |
| Ventana / Salida máxima | 1M entrada / 128K tokens de salida | 1M entrada; multimodal (texto, imagen, audio y video) |
| Control de razonamiento | Adaptive Thinking siempre activo (low a max) | Thinking Levels explícitos (low, medium, high) |
| Entrada / Salida estándar (MTok) | US$ 8,00 / US$ 40,00 | US$ 2,00 / US$ 10,00 hasta 30/11; US$ 4,00 / US$ 20,00 desde 01/12 |
| Lectura en caché (MTok) | US$ 0,20 (97,5% desc.) con escritura explícita paga | US$ 0,10 hasta 30/11; US$ 0,20 desde 01/12 (95% desc., solo implícita) |
| Escritura en caché (MTok) | US$ 10,00 (TTL 5 min) o US$ 16,00 (TTL 1 h) | Sin cargo explícito de escritura (caché implícita automática) |
| Batch y aceleración | Batch -50% (US$ 4 / US$ 20); Fast Mode US$ 16 / US$ 80 (2x) | Batch -50% (US$ 1 / US$ 5 hasta 30/11; US$ 2 / US$ 10 desde 01/12) |
| Artificial Analysis Index (indep.) | 65 (max) y 62 (high) | 60 (high) |
| Epoch Capabilities Index (indep.) | 173 (#1 de 240 modelos) | 170 (#2) |
| Disponibilidad inmediata (GA) | Claude API, Bedrock, Vertex AI y Microsoft Foundry | Google Gemini API / AI Studio (sin nivel gratuito) |
La documentación oficial de precios de Google AI Studio incluye un detalle técnico clave que suele omitirse en comparativas rápidas: en Gemini 4 Carbon, la caché de contexto opera únicamente en modo implícito, sin soporte para escritura y fijación explícita por TTL. En Claude Fable 5.2, Anthropic cobra la grabación explícita (US$ 10,00/MTok para 5 minutos o US$ 16,00/MTok para 1 hora), pero ofrece lectura determinista garantizada a US$ 0,20/MTok, un descuento del 97,5% sobre la entrada estándar. Cuando decenas de subagentes consultan el mismo repositorio o especificación contractual dentro de una ventana fija, fijar el prefijo de forma explícita reduce caídas de acierto por pequeñas variaciones en el orden del contexto.
La matemática de la caché en diciembre y el costo en enjambre
La primera distorsión financiera aparece al revisar el calendario de tarifas de Google. Los precios promocionales de US$ 2,00 en entrada, US$ 10,00 en salida y US$ 0,10 en caché para Gemini 4 Carbon rigen únicamente hasta el 30 de noviembre de 2026. A partir del 1 de diciembre de 2026, la tarifa estándar sube a US$ 4,00 en entrada, US$ 20,00 en salida y US$ 0,20 en lectura de caché.
En ese punto exacto desaparece la ventaja unitaria de Carbon al releer contexto. La caché de contexto sigue aislada por proveedor y por modelo: cuando un enjambre combina dos fabricantes, no comparte memoria de caché entre ellos y cada proveedor paga por calentar su propia copia del contexto base replicado. Lo que iguala en US$ 0,20 por millón de tokens desde diciembre es únicamente la tarifa de lectura dentro de cada ecosistema.
Toda diferencia restante pasa a depender de tres variables: el costo inicial de escribir en caché (US$ 10/MTok en Fable 5.2 frente a caché implícita en Carbon), la entrada sin caché (US$ 8 frente a US$ 4) y, sobre todo, los tokens de salida más el razonamiento interno (US$ 40/MTok frente a US$ 20/MTok, ya que ambos cobran los tokens de pensamiento a tarifa de salida).
Para comprobar el efecto práctico, partimos de los volúmenes globales de los dos ejercicios ya documentados en este sitio y declaramos supuestos analíticos uniformes para poder compararlos. En el primero, tomamos el escenario de 300.000 tokens de código, 5 agentes y 10 iteraciones de nuestra publicación del 11 de noviembre de 2026 sobre Gemini 4 Carbon. Como aquel texto no detallaba el desglose por turno, asumimos aquí 50 llamadas totales: 300 mil tokens escritos al inicio, 14,7 millones leídos en caché, 25 mil tokens nuevos de instrucción y 100 mil tokens totales de salida con razonamiento moderado:
- Gemini 4 Carbon en noviembre (US$ 2 / US$ 10 / caché US$ 0,10): asumiendo acierto completo de caché implícita en los 14,7M tokens leídos, el cálculo cierra en
(0,325 * 2,00) + (14,7 * 0,10) + (0,100 * 10,00)= US$ 3,12. En la publicación del 11 de noviembre, la cifra citada por debajo de US$ 1,50 coincide con el bloque aislado de lecturas en caché (14,7M a US$ 0,10/MTok = US$ 1,47); al sumar la entrada inicial sin caché (US$ 0,65, elevando la entrada total a US$ 2,12) y la salida (US$ 1,00), la cuenta completa da US$ 3,12. - Gemini 4 Carbon desde diciembre (US$ 4 / US$ 20 / caché US$ 0,20): bajo estos mismos supuestos, la factura se duplica a
(0,325 * 4,00) + (14,7 * 0,20) + (0,100 * 20,00)= US$ 6,24. - Claude Fable 5.2 (US$ 8 / US$ 40 / escritura 5m US$ 10 / lectura US$ 0,20): escritura explícita de 0,300M (US$ 3,00) + 0,025M nuevos (US$ 0,20) + 14,7M de lectura (US$ 2,94) + 0,100M de salida (US$ 4,00) = US$ 10,14. Bajo el supuesto controlado de igual volumen de salida, si el esfuerzo eleva la deliberación de 100 mil a 500 mil tokens, el costo de Fable 5.2 sube a US$ 26,14, frente a US$ 14,24 en Carbon en diciembre.
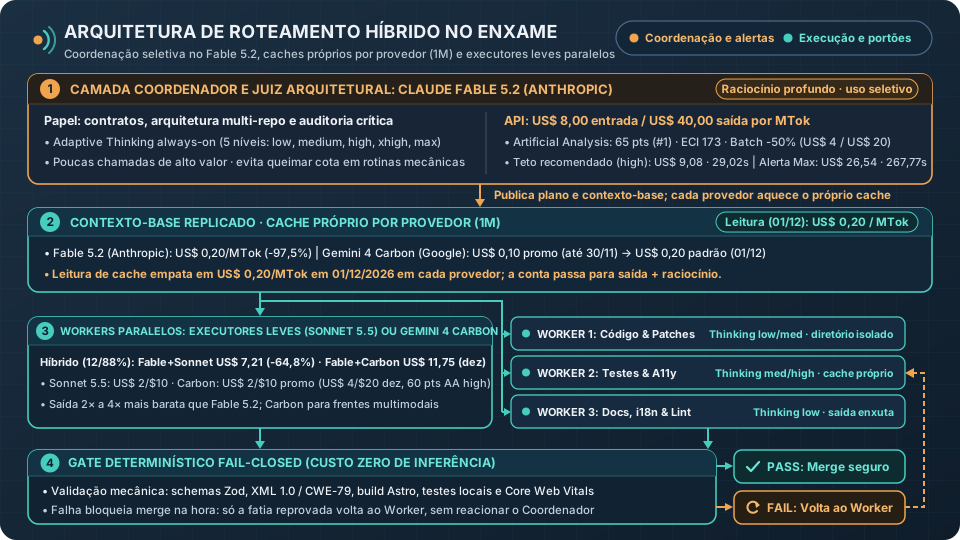
En la segunda simulación proyectamos estas tarifas sobre el volumen total de 6,67 millones de tokens registrado en nuestro ciclo multiagente real. Dado que aquella auditoría anotó el total sin guardar la partición por tipo de llamada, adoptamos como supuesto ilustrativo una distribución con fuerte reutilización de contexto (5,80M en lectura de caché, 0,50M entre entrada nueva y calentamiento promediado a US$ 9,00/MTok en Fable, y 0,37M en salida más razonamiento) y un reparto ilustrativo del 12% para coordinación y 88% para ejecución paralela. El volumen de salida se mantiene idéntico por construcción; si Carbon repitiera la verbosidad 2,4x mayor registrada en el índice de Artificial Analysis (alrededor de 0,888M de salida), su factura posterior a diciembre subiría a cerca de US$ 20,92 (US$ 1,16 + US$ 2,00 + US$ 17,76), prácticamente igualando al enjambre puro en Fable (US$ 20,46):
| Topología sobre ciclo ilustrativo de 6,67M tokens | Caché y entrada nueva | Salida + razonamiento | Costo total estimado |
|---|---|---|---|
| Enjambre 100% Claude Fable 5.2 | US$ 1,16 caché + US$ 4,50 nueva/escritura | 0,37M * US$ 40,00 = US$ 14,80 | US$ 20,46 (US$ 35,26 si se duplica salida) |
| Enjambre 100% Gemini 4 Carbon (desde 01/12) | US$ 1,16 caché + US$ 2,00 nueva | 0,37M * US$ 20,00 = US$ 7,40 | US$ 10,56 (US$ 5,28 hasta 30/11) |
| Híbrido de costo (12% Fable + 88% Sonnet 5.5) | Fable US$ 0,68 + Sonnet US$ 1,50 | Fable US$ 1,78 + Sonnet US$ 3,26 | US$ 7,21 (-64,8% vs. Fable puro) |
| Híbrido multiproveedor (12% Fable + 88% Carbon) | Fable US$ 0,68 + Carbon US$ 2,78 | Fable US$ 1,78 + Carbon US$ 6,51 | US$ 11,75 desde 01/12 (US$ 7,10 en nov.) |
El reparto ilustra los patrones Orchestrator (descomposición y delegación) y Advisor (consulta puntual ante bloqueos), asignando el 12% del flujo a Fable 5.2 (0,696M de lectura en caché, 0,060M de entrada/escritura ponderada a US$ 9,00/MTok y 0,0444M de salida = US$ 2,46) y el 88% restante al modelo ejecutor:
- Ruta de menor costo desde diciembre (12% Fable 5.2 + 88% Claude Sonnet 5.5): aplicando bajo el mismo criterio simétrico de escritura de 5 minutos las tarifas de Sonnet 5.5 (5,104M en caché a US$ 0,10/MTok, 0,440M ponderados a US$ 2,25/MTok entre US$ 2,00 y US$ 2,50, y 0,3256M de salida a US$ 10,00/MTok = US$ 4,76), la suma sin redondeo intermedio cierra en US$ 7,21, un recorte del 64,8% (cerca del 65%) frente al enjambre completo en Fable 5.2. La ventaja se mantiene después de diciembre porque Sonnet 5.5 no duplica su tarifa el 1 de diciembre.
- Ruta multiproveedor con Gemini 4 Carbon (12% Fable 5.2 + 88% Carbon, llamadas síncronas): durante la promoción de noviembre (US$ 2 / US$ 10), la parte en Carbon cuesta US$ 4,65 y el total queda en US$ 7,10; desde el 1 de diciembre (US$ 4 / US$ 20), la fracción de Carbon sube a US$ 9,29 y el par híbrido alcanza US$ 11,75, por encima del Carbon puro síncrono (US$ 10,56).
- Cuándo compensa combinar con Carbon y efecto de la Batch API: en la comparación simétrica, este híbrido multiproveedor se justifica por resiliencia multi-cloud, multimodalidad nativa o mayor techo de razonamiento en el coordinador, no por ahorro bruto. Al mover el 88% de ejecución a la Batch API de Carbon (US$ 2 / US$ 10 y lectura de caché a US$ 0,10 desde el 1 de diciembre, según la pestaña Batch de Google AI Studio), esa fracción baja a US$ 4,65 y el par suma US$ 7,10: por debajo del Carbon puro síncrono (US$ 10,56), pero por encima del Carbon puro también en Batch (US$ 5,28).
Los cinco niveles de esfuerzo, latencia real y riesgo en el tope
El precio por millón de tokens deja fuera el factor operativo que más sorpresas ha generado desde el 9 de noviembre: la expansión del pensamiento interno según sube effort. Los cinco niveles de Fable 5.2 no funcionan como un tope estricto de tokens. Como aclara la documentación oficial de la API, effort es una señal de comportamiento y no un presupuesto fijo, de modo que el modelo sigue consumiendo tokens internos ante problemas complejos incluso por debajo de max.
Las mediciones independientes publicadas por Artificial Analysis (Intelligence Index v5.0.1, verificadas el 12 de noviembre de 2026) muestran con precisión el salto marginal de cada nivel frente a Gemini 4 Carbon en high:
| Configuración medida (Artificial Analysis v5.0.1) | Intelligence Index | Tiempo al 1.er token de respuesta | Velocidad de salida | Tiempo por tarea | Costo promedio por tarea | Tokens de salida en índice |
|---|---|---|---|---|---|---|
Claude Fable 5.2 (low) | 54 (#15) | 8,45 s | 98 tok/s | 6,1 min | US$ 3,10 | 34,9M |
Claude Fable 5.2 (medium) | 56 (#9) | 11,67 s | 95 tok/s | 7,6 min | US$ 3,80 | 41M |
Claude Fable 5.2 (high, API por defecto) | 62 (#3) | 29,02 s | 97 tok/s | 16,9 min | US$ 9,08 | 85,3M |
Claude Fable 5.2 (xhigh) | 62 (#2) | 87,90 s | 103 tok/s | 26,2 min | US$ 14,83 | 144M |
Claude Fable 5.2 (max) | 65 (#1) | 267,77 s | 98 tok/s | 46,8 min | US$ 26,54 | 275M |
Gemini 4 Carbon (high) | 60 (#4) | 67,62 s | 75 tok/s | 27,4 min | US$ 5,48 | 205M |
Conviene precisar qué mide la tercera columna. Los 267,77 segundos (casi cuatro minutos y medio) medidos en Fable 5.2 en max corresponden al tiempo hasta el primer token de respuesta (Time to First Answer Token) tras completar la deliberación interna silenciosa, no a la latencia inicial de red. Una vez que comienza a escribir, la velocidad se mantiene estable (95 a 103 tok/s frente a 75 tok/s en Carbon), pero el nivel max obliga a esperar minutos antes de entregar una sola palabra visible.
Esa curva de rendimientos decrecientes explica por qué high (62 puntos, 29,02 s, US$ 9,08) y xhigh (62 puntos, 87,90 s, US$ 14,83) suelen marcar el límite práctico en ingeniería comercial. Subir de high a max aporta apenas 3 puntos adicionales (62 a 65), pero multiplica por 2,92x el costo medio por tarea (US$ 9,08 a US$ 26,54) y multiplica por 9,2x la espera hasta el primer token de respuesta. En procesos asíncronos, la Batch API recorta entrada y salida a la mitad (US$ 4,00 / US$ 20,00), mientras que el Fast Mode duplica la tarifa (US$ 16,00 / US$ 80,00) para entregar hasta 2,5x más velocidad en bloqueos donde una persona espera en pantalla, nunca dentro de bucles autónomos de subagentes.
En orquestación diaria, dejar ejecutores en max sin restricción de gasto amplifica la verbosidad registrada en las mediciones independientes (275 millones de tokens de salida en el índice de Artificial Analysis frente a una mediana de 72,8 millones entre modelos comparables) y eleva el riesgo de cambios más amplios de lo que exige la tarea. Dado que effort no fija un límite duro de gasto, contener desviaciones exige los mismos controles deterministas en el harness del agente: bloqueo estricto de rutas permitidas por tarea, límites explícitos de max_tokens y validación de esquemas antes de aceptar modificaciones.
Asimetría de benchmarks y qué confirma la medición independiente
Una comparativa honesta debe exponer la asimetría metodológica entre los cuadros de lanzamiento de Google y los de Anthropic. El artículo publicado el 11 de noviembre de 2026 sobre Gemini 4 Carbon recogió las métricas destacadas por Google (SWE-bench Verified 52,8%, CursorBench 78,4% y Zapier AutomationBench 86,2%), mientras Anthropic centró su anuncio del 9 de noviembre en un conjunto diferente de pruebas recientes.
Según las cifras reportadas por Anthropic (2026-11-09), Claude Fable 5.2 alcanzó 69,9% en FrontierSWE v2 (frente a 61,2% atribuidos a Carbon y 62,3% a Opus 5.5), 89,3% en OSWorld 2.1 (frente a 81,5% de Carbon) y 74,6% en Terminal-Bench-Science 0.1 (75,3% en Mythos 5.2, frente a 64,8% de Carbon). En FrontierCode 2.0, la propia tabla de Anthropic deja constancia de condiciones distintas: Fable 5.2 obtuvo 49,1% en Xhigh effort, mientras Gemini 4 Carbon figura con 41,1% evaluado en Medium effort. A su vez, en AutomationBench, la misma tabla sitúa a Carbon por delante (53,9% frente a 51,4% de Fable 5.2).
Sin un protocolo único independiente que ejecute las seis evaluaciones bajo idéntico presupuesto de tokens y esfuerzo, las tablas de cada fabricante valen solo como referencia direccional. Al acudir a las dos referencias independientes comunes verificadas el 12 de noviembre, la distancia resulta acotada: en Epoch AI ECI, Fable 5.2 ocupa el primer puesto entre 240 modelos con 173 puntos (#1) frente a 170 de Carbon (#2); en Artificial Analysis v5.0.1, Fable 5.2 marca 65 en max (#1) y 62 en high (#3) frente a 60 de Carbon (#4), con Carbon registrado en US$ 5,48 por tarea (mostrando la tabla promocional de noviembre de US$ 2 / US$ 10 junto a la medición en la página de análisis) frente a los US$ 9,08 de Fable 5.2 en high. Ninguno de los dos laboratorios publicó tampoco su conteo de parámetros, arquitectura interna ni cómputo exacto de entrenamiento.
Ese equilibrio se invierte al observar la ecuación desde el 1 de diciembre de 2026. Empatada la lectura en caché en US$ 0,20/MTok (anulando ese término) y con una diferencia neta de US$ 6/MTok en la primera escritura (US$ 10/MTok de grabación explícita de 5 minutos en Fable frente a US$ 4/MTok de entrada equivalente en Carbon), la brecha de costo en dólares se reduce a Δ = 4·M_nueva + 6·M_escrita + 20·M_salida, donde cada M denota millones de tokens (de entrada nueva, escritura explícita en caché de 5 minutos y salida, respectivamente). Cuando la salida domina la factura, como en la batería de Artificial Analysis, y los volúmenes de entrada coinciden, Fable 5.2 empata el gasto siempre que consume cerca de la mitad de tokens de salida que Carbon. En la propia batería de Artificial Analysis v5.0.1, Carbon emitió 205 millones de tokens de salida, o 2,4x los 85,3 millones de Fable 5.2 en high; como estimación asumiendo escala lineal con la tarifa estándar de diciembre (US$ 4 / US$ 20), el costo calculado de Carbon por tarea sube a unos US$ 10,96, por encima de los US$ 9,08 de Fable 5.2 en high.
Disponibilidad multi-cloud, retención (ZDR) y bifurcación Fable vs. Mythos
En compras corporativas e infraestructura, la ventaja inmediata de Claude Fable 5.2 en noviembre de 2026 reside en su disponibilidad general desde el primer día. claude-fable-5-2 salió simultáneamente en la API directa de Anthropic, Amazon Bedrock (global.anthropic.claude-fable-5-2), Google Cloud Vertex AI (en modalidades administradas por Google y por Anthropic) y Microsoft Foundry. Mientras Gemini 4 Carbon concentra su acceso documentado de API en la capa de pago de Google (Google AI Studio / Gemini API, sin nivel gratuito), las empresas con contratos activos en AWS o Azure pueden aprovisionar Fable 5.2 de inmediato en Bedrock y Microsoft Foundry.
Este lanzamiento recuerda además al programa cerrado Fairwind de Google, mencionado el 11 de noviembre de 2026, bajo el cual Carbon fue desarrollado para ciberseguridad; en el caso de Anthropic, la separación comercial de exactamente los mismos pesos del modelo en dos regímenes de control figura documentada en su anuncio oficial y en el system card. Anthropic publicó Claude Fable 5.2 para el mercado general con clasificadores de ciberseguridad y biología, sondas de activación, defensas antidestilación (incluido preserved thinking obligatorio para impedir la edición retroactiva del razonamiento en el historial) y redirección transparente hacia modelos previos (Opus 4.8 en ciberseguridad y Opus 5 en biología) cuando una solicitud activa un bloqueo. En paralelo, Claude Mythos 5.2 ofrece los mismos pesos y tarifas sin esos bloqueos especializados, limitado a organizaciones aprobadas en Cyber Verification Program y Life Sciences Verification Program.
Para equipos de seguridad y arquitectura empresarial, el punto más delicado figura en la política de retención de datos. Por defecto, para cualquier cuenta sin excepción aprobada de Zero Data Retention (ZDR) ni adhesión a Enterprise Frontier Safeguards, claude-fable-5-2 exige retención de 30 días para monitoreo de patrones de uso y no admite ZDR (Enterprise Frontier Safeguards opera en beta privada ejecutando controles automatizados sobre registros almacenados dentro de la propia infraestructura del cliente). Antes de habilitar este modelo en IDEs corporativos con modo estricto de privacidad, los administradores deben confirmar si su contrato incluye excepción activa de ZDR.
Matriz de decisión para producción
La elección entre ambos modelos depende de qué restricción domina su operación actual:
- Claude Fable 5.2 (
highoxhigh) encaja como coordinador o revisor de arquitectura cuando la operación requiere disponibilidad inmediata en Bedrock, Vertex AI o Foundry, escritura explícita de caché con lecturas a US$ 0,20/MTok y máxima profundidad de razonamiento en refactorizaciones complejas entre múltiples repositorios. - Claude Sonnet 5.5 (US$ 2 / US$ 10) actúa como candidato a ejecutor estándar (con lectura en caché documentada en US$ 0,10/MTok), sujeto a validar capacidad en tu carga desde diciembre (US$ 7,21 en la simulación ilustrativa híbrida dentro del mismo ecosistema de caché), mientras que Gemini 4 Carbon (
mediumohigh) responde bien en flujos multimodales y endurecimiento de seguridad dentro de la capa de pago de Google AI Studio / Gemini API, aprovechando la tarifa promocional de noviembre o su desempeño en AutomationBench (53,9%). - El nivel
maxy las llamadas a Fable 5.2 quedan fuera de subtareas repetitivas si no existen bloqueos automáticos de alcance. Las rutinas mecánicas se resuelven mejor en niveles intermedios como Opus 5.5 (US$ 4 / US$ 20), Sonnet 5.5 (US$ 2 / US$ 10) o Haiku 5.5 (US$ 0,10 / US$ 0,50 hasta 100 mil tokens), evitando esperas de más de cuatro minutos de deliberación previa.
Los diseños multiproveedor con Fable 5.2 y Carbon envían el mismo código fuente a dos procesadores externos (Anthropic y la capa de pago de Google), lo que exige validar cláusulas de retención y ZDR en ambos contratos; además, como tool_choice forzado devuelve un error HTTP 400 en Fable 5.2, los controles deterministas deben validar esquemas de salida estructurada después de la respuesta en lugar de fijar herramientas en la llamada HTTP.
En enjambres en producción, el modelo de frontera más caro no reemplaza a los modelos menores; justifica su tarifa cuando piensa pocas veces en la cima del grafo para evitar que decenas de ejecuciones económicas fallen a escala.
Fuentes
- Claude Platform Docs — Claude Fable 5.2 Overview & Effort (
2026-11-09, verificado el2026-11-12): especificaciones de contexto (1M), salida (128K), niveles deeffortcomo señal de comportamiento, errores400en muestreo/tool choice forzado, retención de 30 días, restricción de ZDR e IDs multi-cloud. platform.claude.com/docs/en/models/fable-5-2/overview y platform.claude.com/docs/en/build-with-claude/effort - Claude Platform Docs — Pricing (
2026-11-09, verificado el2026-11-12): tabla contractual de entrada/salida, escritura y lectura de Prompt Caching, Batch API (50%desc.) y Fast Mode para Fable 5.2, Opus 5.5, Sonnet 5.5 y Haiku 5.5. platform.claude.com/docs/en/about-claude/pricing - Anthropic — Introducing Claude Fable 5.2 and Claude Mythos 5.2 (
2026-11-09, actualizado2026-11-11, verificado el2026-11-12): anuncio oficial, benchmarks reportados por el proveedor (FrontierCode 2.0, FrontierSWE v2, AutomationBench, OSWorld 2.1, Terminal-Bench-Science 0.1), roles de Advisor y Orchestrator, respaldo hacia Opus 4.8 / Opus 5, Enterprise Frontier Safeguards y programas de verificación. anthropic.com/claude-fable-and-mythos-5-2 - Anthropic — Claude Fable 5.2 and Claude Mythos 5.2 System Card (
2026-11-09, verificado el2026-11-12): evaluaciones de seguridad, salvaguardas y gobernanza de pesos compartidos. anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card - AWS — Claude Fable 5.2 is now available on AWS (
2026-11-09, verificado el2026-11-12): confirmación de disponibilidad general en Amazon Bedrock (global.anthropic.claude-fable-5-2). aws.amazon.com/about-aws/whats-new/2026/11/claude-fable-5-2-aws/ - Google AI Studio — Gemini API Pricing: Gemini 4 Carbon (
2026-11-10, verificado el2026-11-12): vigencia promocional hasta2026-11-30(US$ 2 / US$ 10y cachéUS$ 0,10), ajuste el2026-12-01(US$ 4 / US$ 20y cachéUS$ 0,20) y soporte exclusivo de caché implícita. aistudio.google.com/docs/pricing - Artificial Analysis — Claude Fable 5.2 (
max,xhigh,high,medium,low) & Gemini 4 Carbon (high) (2026-11-12): mediciones independientes del Intelligence Index v5.0.1, Time to First Answer Token, velocidad de salida, duración y costo por tarea. artificialanalysis.ai/models/claude-fable-5-2 y artificialanalysis.ai/models/gemini-4-carbon - Epoch AI — Claude Fable 5.2 & Gemini 4 Carbon (Epoch Capabilities Index) (
2026-11-09, verificado el2026-11-12): clasificación independiente ECI (173vs.170) y registro de parámetros/cómputo de entrenamiento no divulgados. epoch.ai/models/claude-fable-5-2 e epoch.ai/models/gemini-4-carbon

