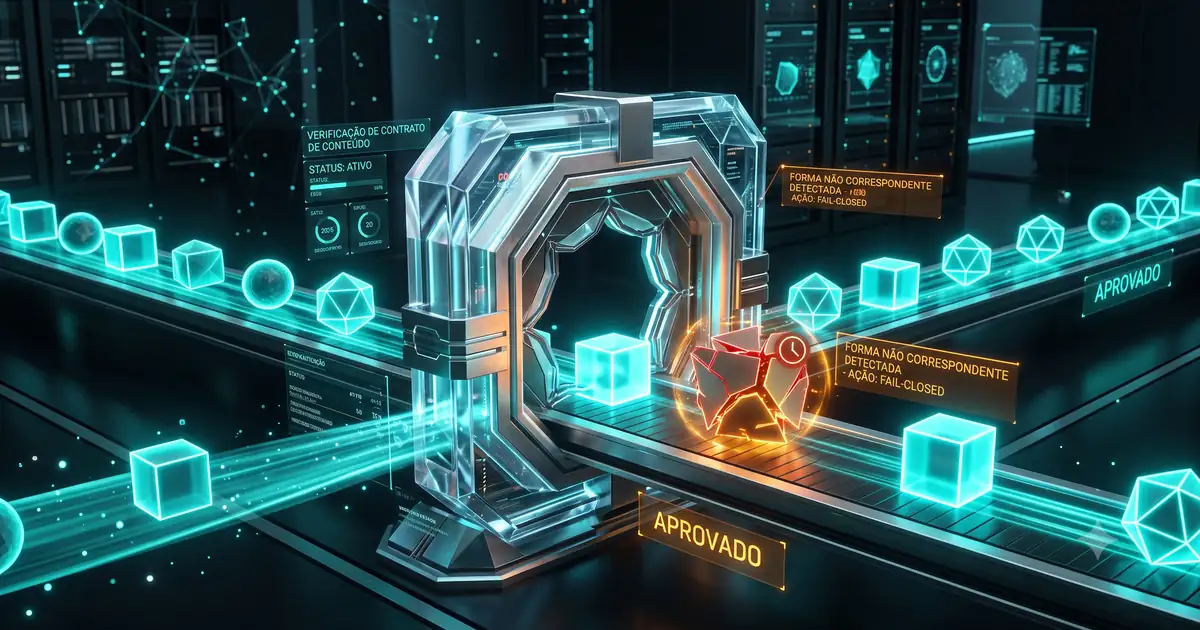
Cuando un pipeline con LLM escribe contenido directo en su repositorio, la pregunta de ingeniería no es “¿y si la IA se equivoca?”: se va a equivocar. La pregunta correcta es: ¿dónde se permite que exista el error? La respuesta de este blog: el error puede existir en el borrador, en el Pull Request, en el preview, en cualquier lugar antes de la producción. Nunca después. Eso no se garantiza con un prompt bien escrito; se garantiza con un contrato ejecutable.
Este post describe el contrato de contenido de Fluxonar, un esquema Zod que valida el frontmatter de cada post en el build, y el caso real de esta semana en el que frenó un error mío, humano, exactamente como frenaría el del LLM.
El contrato es una API, no una convención
El pipeline editorial planeado para este blog terminaría con N8N escribiendo un archivo markdown y abriendo un PR. Entre lo que el LLM escribe y lo que Astro acepta existe un esquema declarado en código:
title: 10 a 70 caracteres, el límite práctico de visualización en un resultado de búsqueda.description: 50 a 160 caracteres, la ventana de la meta description.category: enum cerrado (tech,ia,automacao). No existe “categoría nueva” por accidente.tags: como máximo 6, y cada una tiene que existir en un archivo versionado (tags.json). La lista es la fuente única; el texto libre no entra.pubDate: fecha ISO validada;draft: booleano con predeterminado seguro.
Un markdown que viole cualquier regla hace fallar el build. Y como el deploy del preview ejecuta el build, el PR roto nunca genera un preview aprobable: el error muere en la cinta, visible, con un mensaje que señala el campo. Fail-closed: el camino del error hasta la producción no existe por construcción.
El prompt no es garantía. El contrato ejecutable sí lo es: el build rechaza lo que el modelo invente fuera de lo acordado.
El caso real: la etiqueta que no existía
Al escribir el post anterior —yo, humano, con revisión— usé tres etiquetas: cloudflare, dns, seo. El build falló en el acto: dns no existe en tags.json. No es un bug; es el diseño funcionando. La taxonomía es deliberadamente cerrada: una etiqueta nueva exige tocar un archivo versionado y protegido, es decir, exige una decisión humana explícita; nunca nace de un improviso en medio de un post.
Por qué importa todavía más con un LLM en el circuito: a los modelos les encanta inventar taxonomía. Pida diez posts y usted obtiene cloud, cloudflare, cdn, hospedagem: cuatro etiquetas para la misma cosa, y un archivo de etiquetas que se vuelve un relleno sanitario. Con un enum cerrado, el modelo puede sugerir lo que quiera; el build solo acepta el vocabulario decidido por personas.
Por qué validar dos veces
Un detalle del diseño que parece redundancia y no lo es: la validación existe en dos puntos. El nodo de validación de N8N revisa el frontmatter antes de escribir el archivo (retroalimentación rápida, todavía dentro del pipeline, donde se puede regenerar barato). El esquema de Astro revisa de nuevo en el build (garantía dura, independiente de quién escribió: pipeline, humano, script).
La primera validación es conveniencia; la segunda es seguridad. Si divergen, la conveniencia miente; por eso las dos ejecutan la misma lógica de validación, extraída a un módulo único, con una prueba automatizada que demuestra la paridad. Regla general para cualquier pipeline: la validación de adentro puede ser una copia de la de afuera, nunca una interpretación de ella.
El principio portable
Nada de esto es específico de un blog ni de Astro. La receta, portable a cualquier sistema en el que una IA produce artefactos:
- Declare el contrato en código ejecutable (esquema, tipos, enum), no en un documento de buenas intenciones que nadie ejecuta.
- Cierre los vocabularios. Todo lo que sea clasificación (categoría, etiqueta, estado, tipo) es un enum versionado, nunca texto libre del modelo.
- Acople la validación al camino de la publicación. Si se puede publicar sin pasar por el contrato, el contrato es decorativo.
- Deje que el error sea barato. Una falla en el build de un PR cuesta un clic de regenerar; una falla en producción cuesta credibilidad, y en el caso del contenido, posicionamiento.
El gate humano decide si el texto merece salir al aire. El contrato garantiza que, técnicamente, solo llega a su decisión lo que ya está estructuralmente correcto. Son capas distintas, y es la suma de las dos la que deja que un pipeline de IA opere sin miedo.


