El vocabulario de 2026 fijó una fórmula: agente = modelo + harness. El harness es toda la infraestructura alrededor del modelo: el bucle, las herramientas, el estado, el contexto, los guardrails y la verificación. La palabra viene de la jerga de prueba de software, donde el harness es el andamio que corre el código bajo condiciones controladas. Tiene sentido: es exactamente eso lo que es.
La parte que los textos sobre el tema explican bien es la anatomía. La parte que casi ninguno muestra funcionando es la última de la lista: la verificación.
Este es el 16.º post de este blog, escrito por un proceso asistido por IA con compuerta humana obligatoria. El harness que sostiene esto no tiene nada de exótico: un schema, una batería de pruebas, un job de CI y algunos archivos de texto versionados. Este post abre el registro de lo que esas piezas frenaron de verdad. Y termina con lo que no atraparon, que es la parte más útil.
La regla de este post
Aquí solo entra un defecto que está registrado en un archivo versionado del repositorio: la prueba que falló, el comentario que quedó en el código, la lección anotada en la memoria del proyecto. El repositorio es privado; por eso, cada caso trae el fragmento o el hecho verificable, no un enlace que el lector no podría abrir.
Es la misma regla que aplico a un número de fuente externa. Si no se puede auditar, no entra, ni cuando el dato es mío.
Lo que el harness frenó
| Compuerta | Lo que atrapó | Lo que iría al aire |
|---|---|---|
| Contrato Zod del frontmatter | etiqueta fuera de la taxonomía; description con 162 caracteres de 160 permitidos, dos veces seguidas | post con meta truncada en Google y etiqueta huérfana sin ruta |
| Lighthouse en el runner Linux | CLS de 0,31 que mi máquina no reproducía | layout que salta en la pantalla de quien lee por el celular |
| Auditoría de SEO | directiva inventada en robots.txt: nota 100 → 92 en las tres páginas medidas | caída de SEO en el sitio entero por un archivo de 15 líneas |
| Auditoría de accesibilidad | sección nueva que cierra en h2 antes del pie en h4: 100 → 98 | jerarquía de títulos rota para el lector de pantalla |
test:aria | ítem de menú marcado en la página equivocada — bug que ya mordió dos veces | navegación que miente sobre dónde está el lector |
test:tags y test:home | conteo mostrado distinto de los posts listados; borrador que se vuelve ruta pública | número equivocado delante del lector y texto no aprobado en el aire |
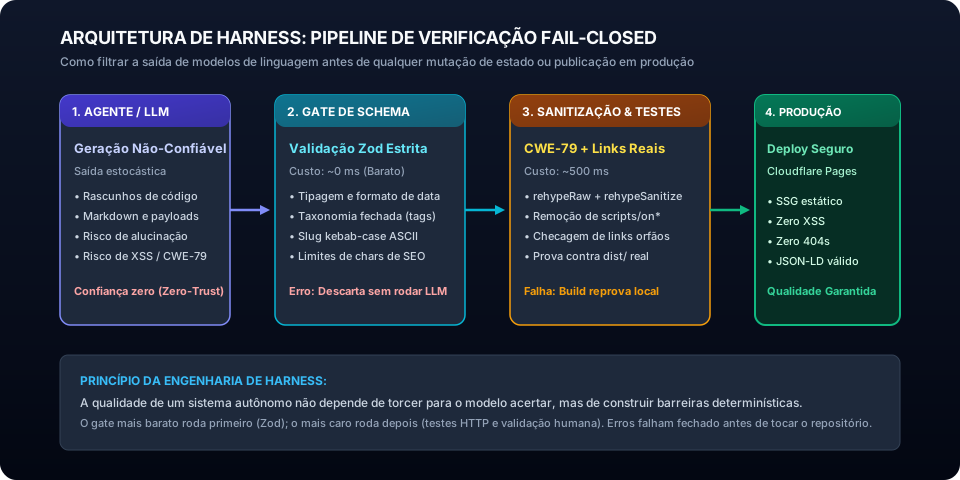
test:sanitize | HTML malicioso incrustado en markdown (CWE-79) | ejecución de script de un tercero dentro del post |
Tres de esos merecen la historia entera.
La compuerta más barata es el contrato
Todo post pasa por un schema declarado en código antes de existir como página: título entre 10 y 70 caracteres, descripción entre 50 y 160, categoría dentro de tres valores fijos, etiquetas obligatoriamente presentes en un archivo versionado aparte. Una etiqueta fuera de la lista derriba el build: el post no queda feo, no nace. Ya escribí sobre el diseño de esa pieza en el post sobre el contrato de contenido.
El detalle que interesa aquí es otro: el error que más se repite en esa compuerta es mío, no del modelo. La description se pasó del límite con 162 caracteres en los posts 14 y 15, en rondas seguidas, cada una por dos caracteres. Un contrato que solo desconfía de la máquina habría dejado pasar los dos.
La compuerta tiene que correr en el ambiente que publica
El caso más instructivo del acervo es un CLS de 0,31 — tres veces el límite tolerable — que solo aparecía en el runner Linux del CI. En mi máquina, el mismo commit medía cerca de 0,001.
No era fluctuación de medición. La fuente de fallback que el sistema elige mientras carga la webfont es distinta en cada sistema operativo, y el cambio hacía reflow de la página entera en Linux. La corrección fue declarar un @font-face de fallback con size-adjust y ascent-override calculados a partir de las métricas reales de las fuentes, en lugar de degradar la tipografía. El CLS fue a cero.
La lección cabe en una línea: “pasó en mi máquina” es una afirmación sobre mi máquina. La compuerta que vale es la que corre donde el sitio se construye de verdad.
En un archivo con validador, solo entra lo que define el estándar
Cuando publiqué el llms.txt del sitio, quise anunciarlo en el robots.txt con una línea propia, LLM-Content:. Parecía inofensivo: un archivo de texto, una directiva más.
La auditoría de SEO de Lighthouse bajó la nota de 100 a 92 en las tres páginas medidas: para el validador, una directiva desconocida es un error de sintaxis, no una extensión. Y la propuesta del llms.txt ni siquiera prevé puntero alguno; el archivo se encuentra por la ruta fija, igual que el propio robots.txt.
Hoy ese intento vive como comentario dentro del archivo, explicando por qué no volvió. El repositorio documenta su propia cicatriz, que es, ella misma, una pieza del harness.
Nota de actualización (23/10/2026): este texto se publicó el 14/08/2026. El 22/09/2026 el proyecto pasó a validar en local (
astro check,test:all, Lighthouse) y el workflow de CI quedó solo conworkflow_dispatch; ya no hay job automático en el PR ni X en el PR. La lección sobre la compuerta no bloqueante sigue válida, pero el mecanismo descrito abajo es el del período anterior.
La compuerta que no bloquea, y aun así funciona
Una elección del CI de este proyecto suele sorprender: el job de Lighthouse corre con continue-on-error. No impide el merge por sí solo.
El motivo es honesto. Los runners compartidos tienen variación real de CPU y disco entre ejecuciones; un umbral absoluto de nota se vuelve una reprobación aleatoria por el hardware del día, no por una regresión del sitio. Y una compuerta que reprueba sin motivo enseña al equipo a hacer clic en “merge de todos modos”: cuando eso pasa, la compuerta dejó de proteger y se volvió decoración.
Entonces se diseñó para otra función: el script sale con error cuando el LCP supera los 2500 ms o el CLS supera 0,1, el job aparecía con una X visible en el PR, en la época en que el CI corría en el PR, y la decisión de seguir era humana y consciente. Las compuertas deterministas — contrato, sanitización, accesibilidad, 404, navegación — esas sí son obligatorias y traban el merge.
La distinción vale para cualquier harness: la compuerta que mide algo con varianza informa; la compuerta que verifica un invariante bloquea. Cambiarlas de lugar produce o un proceso flojo, o un proceso que todo el mundo aprende a esquivar.
Guardrail que es estado, no recordatorio
El ejemplo más reciente es de hace cuatro días. El espacio de anuncio del sitio reservaba altura en seis lugares sin existir cuenta de anuncio alguna: un rectángulo punteado con el texto “Anuncio”, visible para el lector.
La corrección no fue comentar el código con un <!-- descomentar depois -->. El componente pasó a no renderizar nada mientras la variable de entorno esté vacía. Encender la monetización, el día en que el acervo lo justifique, es completar la variable en el panel del hospedaje: los seis espacios vuelven solos, con la altura reservada anti-CLS intacta.
La diferencia entre las dos soluciones es dónde vive la decisión. El comentario depende de que alguien recuerde; la variable de entorno es estado del sistema. En un proceso con un agente en el medio, el guardrail colgado de la memoria de alguien es el primero en caer.
Lo que ninguna compuerta atrapó
Aquí el post se vuelve útil de verdad.
Colisión de CSS, dos veces. Una regla antigua borró el display de un elemento y la tarjeta de la página de inicio colapsó a altura cero. Ninguna prueba lo acusó, y no tenía que acusarlo: la automatización de este proyecto prueba estructura y geometría, no el acabado. Quien lo vio fue un humano mirando la pantalla.
Falso defecto y falso alivio en la misma herramienta. Una captura de pantalla automatizada fotografió el fallback de las fuentes e inventó un defecto que no existía: faltaba esperar a que terminara el pintado. Días después, una imagen que faltaba en la captura casi quedó enterrada por la explicación cómoda (“es solo la carga diferida”) y era un bug de CSS de verdad. La prueba que separa los dos casos cuesta un minuto; la explicación cómoda cuesta un defecto en producción.
Texto verdadero en el lugar equivocado. Un aviso interno de trabajo quedó público durante días en una página legal. Ninguna auditoría reprueba eso: el HTML era válido, la nota era honesta, el lugar era el que estaba mal.
El harness no sustituye la compuerta humana: cambia lo que el humano necesita mirar. La máquina se queda con lo repetitivo, lo objetivo y lo tedioso. Para la persona queda exactamente lo que hace mejor: juicio y acabado.
El mismo diseño en un sistema multiagente: BRUpgrade
Nota de actualización (29/10/2026): esta sección incorpora el post sobre BRUpgrade, publicado el 26/09/2026, que dejó de existir como página propia.
Transparencia: BRUpgrade es una plataforma desarrollada por el autor de este blog para orquestar agentes de IA con gobernanza. Entra aquí porque aplica la misma regla de este post a un problema mayor: varios agentes trabajando en el mismo proyecto.
Cuando varios agentes colaboran sin regla, el resultado suele ser conversación en círculo, gasto de tokens sin control y una tarea que no llega a un veredicto. BRUpgrade organiza el trabajo como una empresa:
- Cargos con alcance cerrado. Cada agente ocupa una función declarada, como arquitecto de software, ingeniero de datos, diseñador de interfaz, especialista en seguridad o tester, y solo accede a las herramientas e instrucciones del propio cargo. Quien decide la arquitectura no es el mismo agente que implementa.
- Modelo por complejidad. La tarea de razonamiento pesado va a un modelo más fuerte; el triaje y el formato de documento, a uno más rápido y barato.
- Consejo antes de la ejecución. Una demanda compleja empieza con una sesión en la que sillas especializadas analizan seguridad, viabilidad técnica, impacto y costo, y publican un acta.
- Aprobación humana central. Nada se vuelve ejecución de código sin autorización explícita del operador.
- Compuerta de prueba ejecutable. El agente no cierra la tarea diciendo “listo”: el trabajo pasa por pruebas automatizadas, comprobación de tipos o lint, que responden pasó o reprobó.
- Ejecución aislada. Cada agente trabaja en un directorio propio, con comandos restringidos y sin acceso libre al sistema operativo.
- Registro de costo. Cada ciclo graba los tokens de entrada y de salida, el costo acumulado por proyecto y el diario de las decisiones tomadas.
La plataforma está hecha en React 19, TypeScript y Vite, con contratos validados por Zod. El principio es el de este post a mayor escala: quien decide la calidad es la verificación que corre sola, no la promesa del agente.
Cómo armar el suyo, sin plataforma alguna
- Contrato antes del generador. Un schema que hace fallar el build vale más que cualquier instrucción en el prompt. El prompt pide; el contrato exige.
- Compuerta mecánica antes del revisor caro. Lo que un script puede reprobar no debe llegar al modelo grande: en el ciclo que abrí en números en este post, una comprobación barata evitó que tres revisores redescubrieran el mismo defecto trivial.
- Mida en el ambiente que publica. El sistema operativo, la fuente, la red y la CPU del CI no son los suyos.
- En un archivo con validador, solo lo que define el estándar. El resto se vuelve comentario.
- Guardrail como estado, no como recordatorio. Variable de entorno, no una nota en el código.
- Declare lo que la compuerta no cubre. La lista de lo que la automatización no atrapa es lo que dice por dónde tiene que pasar el ojo humano.
Ningún ítem de esa lista exige plataforma de agentes, orquestador comercial o base vectorial. Son un schema, algunos scripts de prueba, un archivo de CI y disciplina de registro, sobre el git que usted ya tiene.
El beneficio, medido
El beneficio de un harness no es la sensación de control. Es la lista de errores que frenó antes de que costaran algo: una taxonomía rota, dos descripciones desbordadas, un CLS tres veces por encima del límite, ocho puntos de SEO en todas las páginas, dos puntos de accesibilidad, un ítem de navegación que mentía. Todos capturados por piezas que corren en minutos y no cuestan nada por mes.
Y el precio honesto: ninguna de esas compuertas me hizo más rápido. Todas me hicieron más difícil de estropear, que, en un proceso en el que una máquina escribe el borrador, es la métrica que importa.
Fuentes
- Definición de agent harness (infraestructura alrededor del modelo: herramientas, memoria, estado, contexto y guardrails) y el origen del término a inicios de 2026, con atribución disputada — Agent harness, Wikipedia (enciclopedia), verificado el 2026-08-14.
- Límites del contrato de contenido (título 10-70, descripción 50-160, categoría cerrada, etiquetas validadas contra un archivo propio) —
src/content/post-schema.mjs(registro interno del proyecto), verificado el 2026-08-14. - Compuertas obligatorias del PR y la decisión explícita de mantener el job de Lighthouse como no bloqueante, con la justificación de la varianza de los runners —
.github/workflows/content-check.yml(registro interno del proyecto), verificado el 2026-08-14. - Metas de LCP < 2500 ms y CLS < 0,1 aplicadas como falla de ejecución —
tests/lighthouse/run-lighthouse.mjs(registro interno del proyecto), verificado el 2026-08-14. - Registro de la directiva inventada que bajó el SEO de 100 a 92, preservado como comentario en el propio archivo —
public/robots.txt(registro interno del proyecto), verificado el 2026-08-14. - Los demás defectos citados (CLS dependiente del sistema operativo, orden de títulos, colisiones de CSS, falso defecto en la captura de pantalla, aviso interno en producción) están anotados en la memoria versionada del proyecto —
MEMORIA-PROJETO.md(registro interno del proyecto), verificado el 2026-08-14. - Seguridad y control de ejecución en sistemas de agentes, referencia de la sección sobre BRUpgrade — OWASP Top 10 for Large Language Model Applications (guía de seguridad), verificado el 2026-09-26.
- Organigrama, contratos Zod y registro de ejecución de BRUpgrade — repositorio interno de la plataforma (registro interno del autor, sin enlace público), verificado el 2026-09-26.
- Metodología declarada: las notas de Lighthouse citadas son de ejecuciones del perfil fijo de este proyecto (móvil emulado, throttling simulado), locales o en el CI; no son mediciones de campo de usuarios reales.


