Quando um pipeline com LLM escreve conteúdo direto no seu repositório, a pergunta de engenharia não é “e se a IA errar?” — ela vai errar. A pergunta certa é: onde o erro é permitido existir? A resposta deste blog: o erro pode existir no rascunho, no Pull Request, no preview — em qualquer lugar antes da produção. Nunca depois. Isso não se garante com prompt bem escrito; garante-se com contrato executável.
Este post descreve o contrato de conteúdo do Fluxonar — um schema Zod que valida o frontmatter de cada post no build — e o caso real desta semana em que ele barrou um erro meu, humano, exatamente como barraria o do LLM.
O contrato é uma API, não uma convenção
O pipeline editorial daqui (descrito em outro post) termina com o N8N escrevendo um arquivo markdown e abrindo um PR. Entre o que o LLM escreve e o que o Astro aceita existe um schema declarado em código:
title: 10 a 70 caracteres — o limite prático de exibição em resultado de busca.description: 50 a 160 caracteres — a janela da meta description.category: enum fechado (tech,ia,automacao). Não existe “categoria nova” por acidente.tags: no máximo 6, e cada uma precisa existir num arquivo versionado (tags.json). A lista é a fonte única; texto livre não entra.pubDate: data ISO validada;draft: booleano com default seguro.
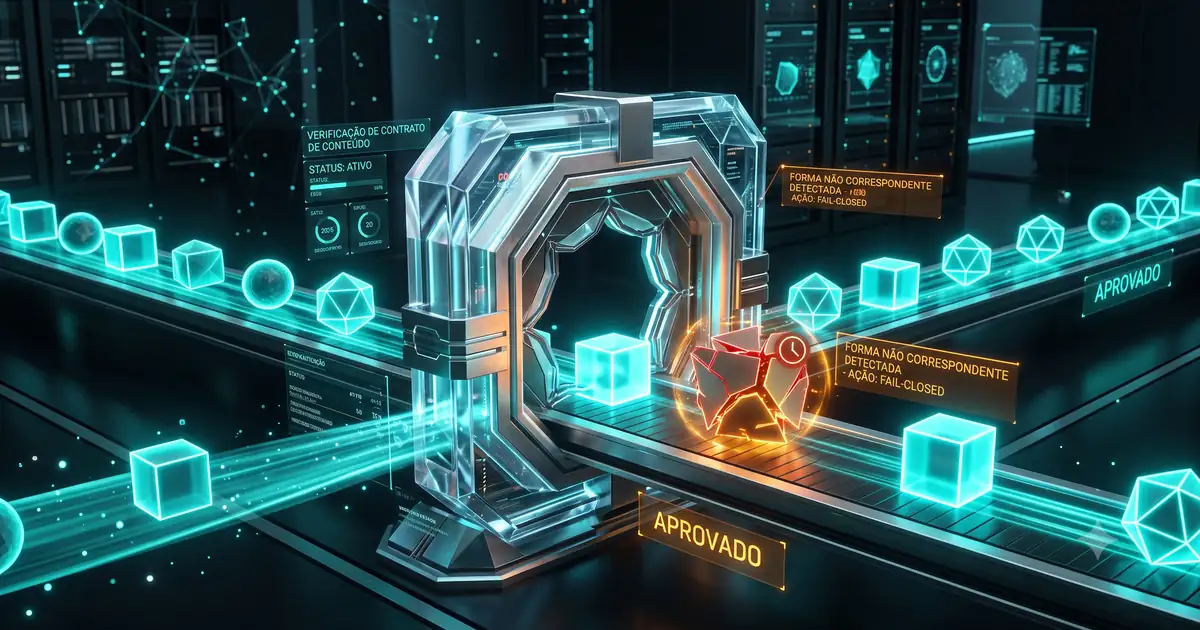
Markdown que viole qualquer regra falha o build. E como o deploy do preview roda o build, o PR quebrado nunca gera preview aprovável — o erro morre na esteira, visível, com mensagem apontando o campo. Fail-closed: o caminho do erro até a produção não existe por construção.
Prompt não é garantia. Contrato executável é: o build recusa o que o modelo inventar fora do combinado.
O caso real: a tag que não existia
Escrevendo o post anterior — eu, humano, com revisão — usei três tags: cloudflare, dns, seo. O build falhou na hora: dns não existe em tags.json. Não é bug; é o desenho funcionando. A taxonomia é deliberadamente fechada: tag nova exige mexer num arquivo versionado e protegido, ou seja, exige uma decisão humana explícita — nunca nasce de improviso no meio de um post.
Por que isso importa mais ainda com LLM no circuito: modelos adoram inventar taxonomia. Peça dez posts e você ganha cloud, cloudflare, cdn, hospedagem — quatro etiquetas para a mesma coisa, e um arquivo de tags que vira aterro sanitário. Com enum fechado, o modelo pode sugerir o que quiser; o build só aceita o vocabulário decidido por gente.
Por que validar duas vezes
Um detalhe do desenho que parece redundância e não é: a validação existe em dois pontos. O nó de validação do N8N confere o frontmatter antes de escrever o arquivo (feedback rápido, ainda dentro do pipeline, onde dá para re-gerar barato). O schema do Astro confere de novo no build (garantia dura, independente de quem escreveu — pipeline, humano, script).
A primeira validação é conveniência; a segunda é segurança. Se elas divergem, a conveniência mente — por isso as duas rodam a mesma lógica de validação, extraída para um módulo único, com teste automatizado provando a paridade. Regra geral para qualquer pipeline: a validação de dentro pode ser cópia da de fora, nunca uma interpretação dela.
O princípio portável
Nada disso é específico de blog ou de Astro. A receita, portável para qualquer sistema onde uma IA produz artefatos:
- Declare o contrato em código executável (schema, tipos, enum) — não em documento de boas intenções que ninguém executa.
- Feche os vocabulários. Tudo que for classificação (categoria, tag, status, tipo) é enum versionado, nunca texto livre do modelo.
- Acople a validação ao caminho da publicação. Se dá para publicar sem passar pelo contrato, o contrato é decorativo.
- Deixe o erro ser barato. Falha no build de um PR custa um clique de re-gerar; falha em produção custa credibilidade — e no caso de conteúdo, ranqueamento.
O gate humano decide se o texto merece ir ao ar. O contrato garante que, tecnicamente, só chega à decisão dele o que já está estruturalmente correto. São camadas diferentes — e é a soma das duas que deixa um pipeline de IA operar sem medo.